不用买服务器:5 分钟养一个会记忆、能进微信、还会自己干活的 AI
你每天打开 AI、问一句、答一句、关掉窗口,第二天它又不认识你了。问题不在模型不够聪明,而在形态。腾讯轻量云的 LightVela 把 Agent 放云端、把入口放进微信:不用买服务器,不用碰 Docker,接上微信就能用,还能装 Skill、建定时任务,到点自己开工把结果发给你。
你有没有算过这样一笔账:每天打开 AI,问一句,它答一句,关掉窗口,第二天再来一遍——它不记得你是谁,不记得你上次在做什么,也不记得你讨厌它啰嗦。
一年下来,你用它的次数可能有几百次,但你对它来说,每次都是陌生人。
问题不在模型不够聪明。现在的模型写文案、改代码、查资料都够用了。真正卡住的是形态:你手里的 AI 是一个「窗口」,你问它才动,你不问它就消失。你的电脑关了,它就下班了。
而最近被反复讨论的 Personal AI Agent,解决的恰恰是这件事:不是让 AI 更会回答,而是让它能接着干。
腾讯轻量云团队做的 LightVela,就是这条路上一个挺有代表性的产品。它跑在云上,能接进微信、QQ、飞书,能记住你,能装技能,能定时自己开工。你不用买服务器,也不用碰 Docker。
这篇文章,我们从零搭一个出来。整套流程跑通大概五分钟,但真正有意思的在后半段。
先把话说清楚:它跟 Muse 不是一回事
先泼一盆冷水,免得期待错位。
Meta 的 Muse 强调的是 Personal AI Agent 加上独立的 Secure VM——让 Agent 在一个属于你自己的安全计算环境里代表你干活。LightVela 走的不是这条路,它更准确的定位是「云端 Agent 托管产品」,跑在里面的核心叫 Hermes Agent。
你可以这样理解它的结构:
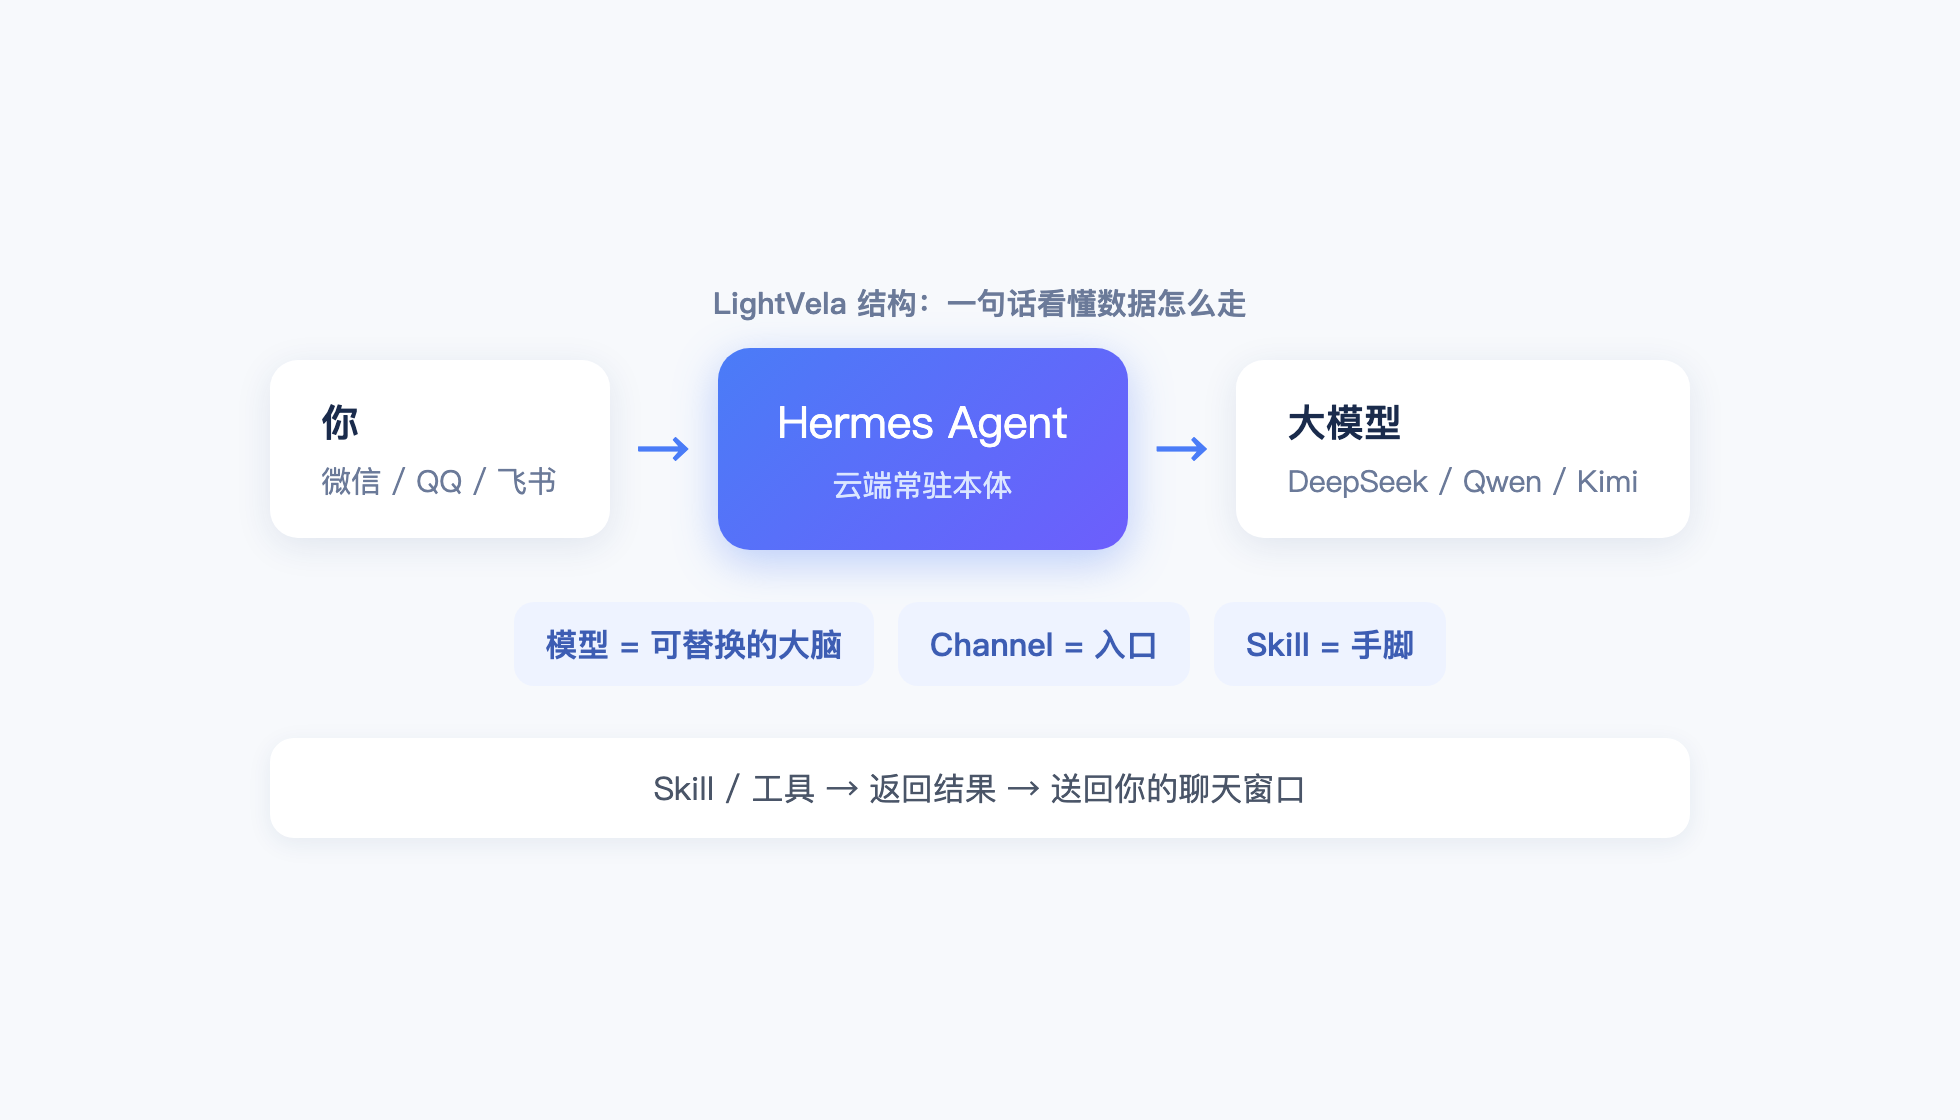
你在微信里发一句话,消息进到云端的 Hermes Agent,Agent 调模型思考,需要动手时调 Skill 和工具,最后把结果送回你的聊天窗口。
四件事构成了这个结构,值得单独记住:
- Hermes Agent 是本体,长期在云端运行,它的人设、记忆、文件、 Skill 都挂在它身上
- Model 是大脑,DeepSeek、Qwen、Kimi、GLM、Claude、GPT 都能接
- Channel 是入口,微信、QQ、企业微信、飞书、Telegram、Discord、Slack 都支持
- Skill 是手脚,让它获得浏览网页、搜信息、整理日报这类额外能力
这里有个判断我觉得比产品本身更重要:模型不等于 Agent。
你今天让 Hermes 用 DeepSeek,明天换成 Kimi,它的人设、长期记忆、文件和定时任务还在。换模型只是换了个大脑,身体还是那个身体。这一点决定了它值得长期投入——你不是在养一个模型,你是在养一个 Agent。
五分钟,先把 Hermes 跑起来
第一步很无聊,但必须走。
进 LightVela 官网登录(国际站支持 Google 或 GitHub 账号),开通套餐后进「我的 Hermes」,创建一个 Hermes Agent。等十几秒,看到状态变成 Running,基础环境就好了。
> 新用户目前有一个月的免费体验,还送体验积分。第一次玩先别折腾 API Key,直接用官方送的积分跑起来,等确定喜欢什么模型再配自己的 Key。具体权益会调整,以订阅页实时显示为准。
创建完你会看到几个入口:模型、通道、技能,以及后面的对话、记忆、人设、定时任务、云存储。
到这一步,你已经有一台 7×24 小时在线的 Agent 了。虽然它还什么都不会。
接进微信:国内用户最心动的一步
这一步是 LightVela 对国内用户杀伤力最大的地方,也是它跟一堆「网页版 Agent」拉开差距的地方。
路径是:我的 Hermes → 通道 → WeChat → 授权接入。
页面出二维码,手机微信扫一下,按提示完成授权,添加出现的机器人账号。然后给它发两个字:你好。
几秒钟收到回复,它就住进你的微信了。整个过程不需要你自己部署机器人服务器,不需要一台常开的电脑,也不需要备案域名。
除了微信,当前还支持 QQ、企业微信、飞书、Telegram、WhatsApp、Discord、Slack。QQ 支持群里 @ 机器人,飞书也支持群聊 @。
于是会出现这样的场景:微信里它是你的私人助理,飞书里它是工作助手,QQ 群里它帮大家答问题。而只要连的是同一个 Hermes Agent,人格、长期记忆和 Skill 都是共享的——你不需要每个平台重新养一个 AI。
需要注意的是,各聊天窗口自己的即时聊天记录并不实时互相同步。它是「一个 Agent,多个入口」,不是「多端同步聊天记录」。
模型是大脑,Hermes 才是身体
基础流程跑通之后,再考虑换模型。
进「我的 Hermes → 模型」,有三种接法:Coding Plan、按量 API、自定义模型。第三种可以连任何兼容 OpenAI Chat Completions 协议的端点,自由度最高。
官方目前列出的供应商包括 DeepSeek、Qwen、MiniMax、Kimi、GLM、豆包、Xiaomi MiMo,也包括 OpenAI、Anthropic、Gemini、OpenRouter。
配置就是三步:选模型 → 填 API Key → 设为默认。
有个细节要提醒:一个 Hermes 同一时间只有一个生效模型,换模型时新配置会覆盖旧的默认模型。但不会把记忆一起删掉——这正是前面说的「换大脑不换身体」。
给它一个 Soul:从「能聊天」变成「是我的」
到这里,它还只是一个能聊天的 AI。接下来这一步,才开始有「这是我的 Agent」的感觉。
LightVela 有个设计叫 Soul。它会写进 Hermes 的 SOUL.md,负责定义这个 Agent 的稳定角色、语气、优先级和行为边界。你可以用官方推荐的人设,也可以上传自己的 Markdown 文件。
我会这样写我的:
Role:
你是我的长期私人 AI 助理和研究搭档。
Voice:
默认使用中文。
表达简洁,先给结论,再给依据。
不要为了显得聪明而堆砌术语。
Behavior:
收到复杂任务后先拆解任务,再执行。
不确定的信息必须明确标注。
能自己解决的问题不要反复询问我。
需要我决定时,只提出最关键的问题。
Boundaries:
发送外部消息前先确认。
删除文件、修改重要数据、产生费用前必须确认。
涉及账号、密钥和隐私信息时采取保守策略。
注入之后,在聊天窗口发 /new 开一个新会话,新的人设就加载了。
这里最容易搞错的一件事:Soul 不要拿来塞项目资料。
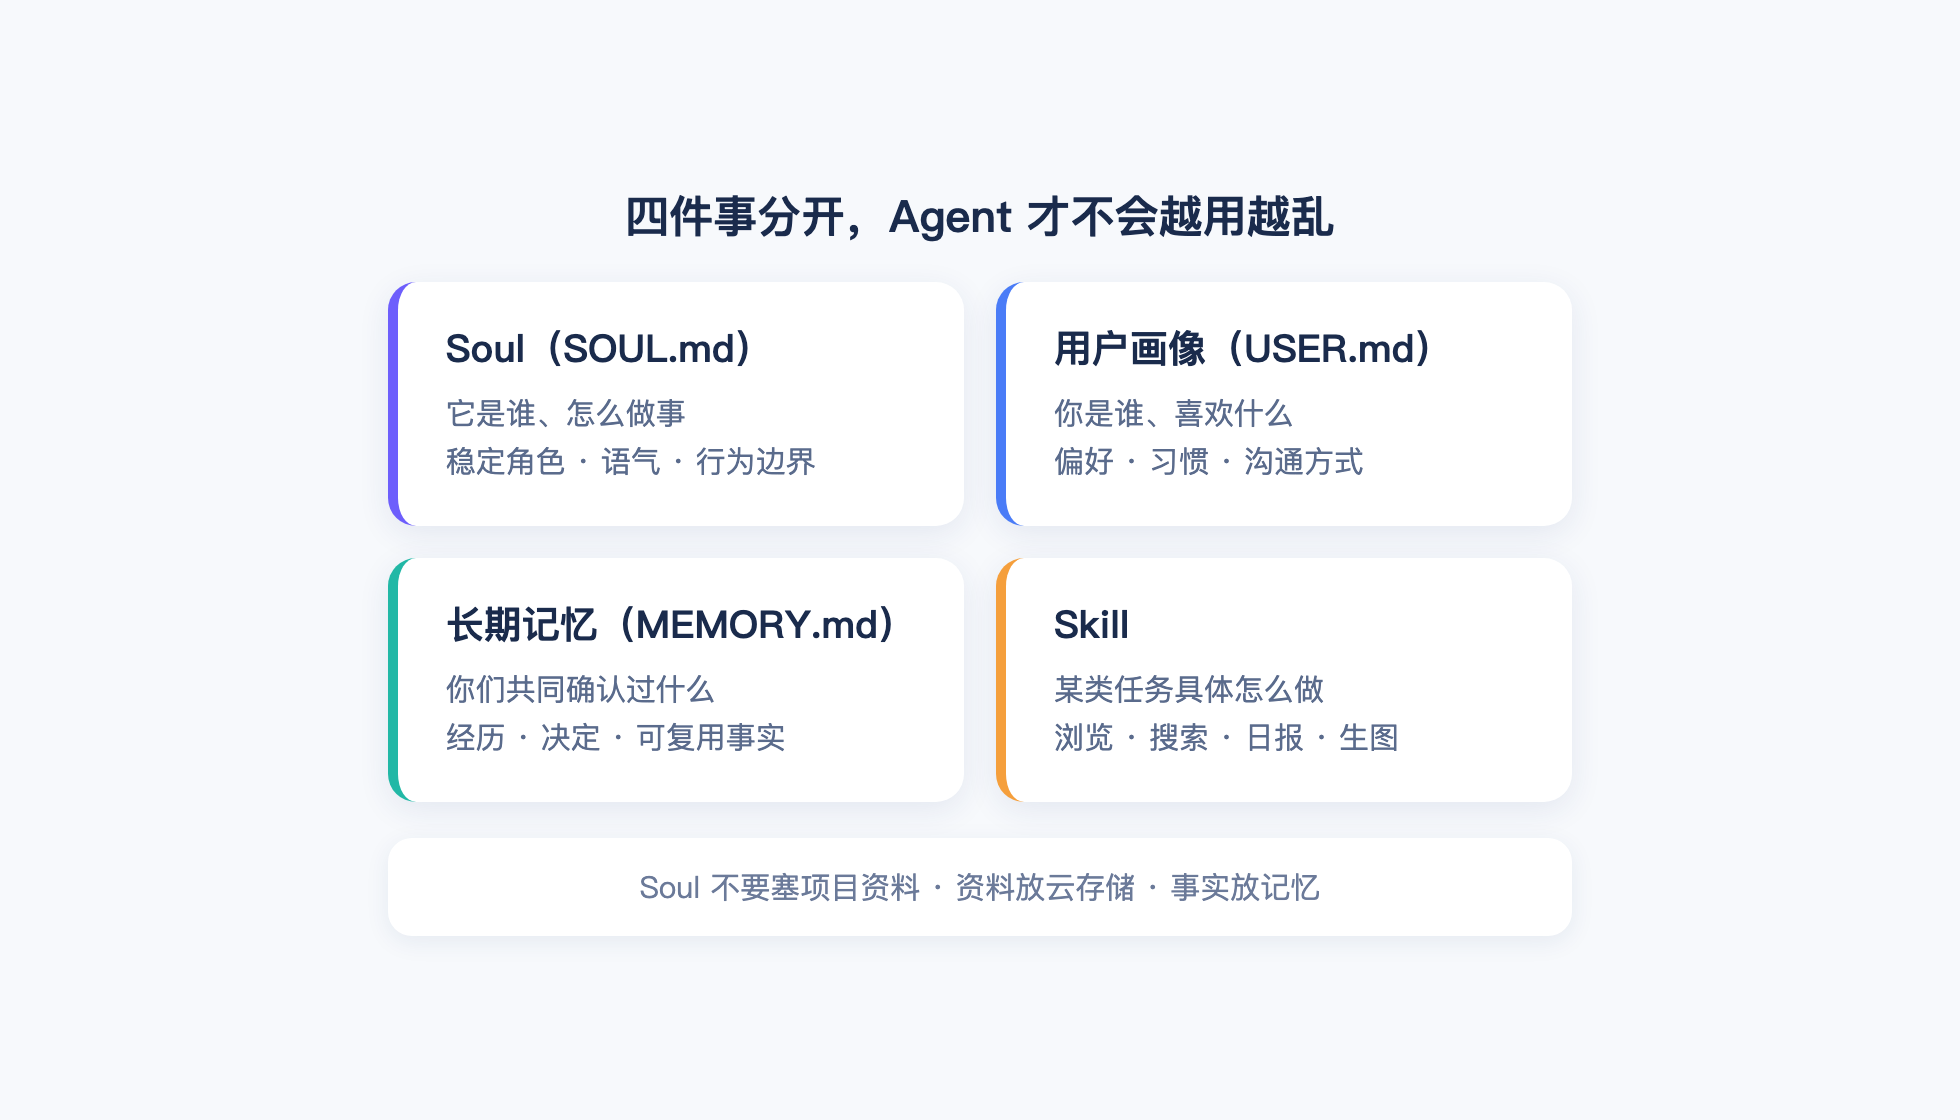
四件事必须分开:Soul 管「它是谁、怎么做事」,用户画像管「你是谁、喜欢什么」,长期记忆管「你们之前确认过什么」,Skill 管「遇到某类任务具体怎么做」。
混在一起,Agent 就会越用越乱——你会发现它一会儿记住了你的口味,一会儿又忘了项目背景,还经常把资料当成人设念给你听。
长期记忆和云存储,别搞混
接下来可以在微信里直接对它说:
> 请记住:1. 默认和我用中文交流。2. 我喜欢先看结论,再看详细分析。3. 做资料研究时,不确定的信息必须标注。4. 给我多个方案时说明各自优缺点。5. 涉及发送消息、删除文件、付款等外部操作,先征求我的确认。
Hermes 的长期记忆不是把所有聊天记录一股脑塞进上下文。它的记忆体系是分层的:USER.md 存「你是谁、你的偏好」,MEMORY.md 存共同经历、决定和可复用事实,另外还有会话档案和 Skills 等不同层次。
用一段时间之后,你可以直接问它:「你现在对我有哪些了解?」或者「还记得我们上次讨论的那个项目吗?」
能答上来,它就从一次性聊天机器人变成了长期 Agent。
而项目资料、PDF、表格这类大块内容,应该放进云存储(单个文件支持到 1 GB),让它去读,而不是塞进长期记忆。
一句话区分:Memory 存「应该记住的事实」,Cloud Storage 存「以后可能需要查阅的资料」。
你可以直接这么用:
> 阅读「项目资料」文件夹里的内容。先不要修改任何文件。先告诉我:1. 这个项目的目标是什么;2. 当前有哪些重要信息;3. 哪些地方存在冲突;4. 哪些信息还缺失;5. 下一步最值得做什么。
装 Skill,让它长出「手和脚」
只有模型,Agent 主要负责「想和说」。有了 Skill,它才开始「做」。
Skill 目前主要来自 Skills.sh 和 ClawHub,能扩展网页浏览、信息搜索、日报整理、图片生成这些能力。稳妥的做法是让 Hermes 自己装:
> 帮我从 Skills.sh 或 ClawHub 安装 agent-browser。安装之前先告诉我它需要哪些权限,有什么风险,等我确认后再安装。
装完让它更新技能列表,然后就可以派活了:
> 使用浏览器搜索今天最值得关注的 5 条 AI 新闻,每条给我:标题、发生了什么、为什么重要、原始来源。最后总结今天最值得关注的趋势。
这时候你会明显感觉到区别:你不是在问 AI 一个问题,而是在给 Agent 派一件工作。
不过 Skill 本质上是能执行操作的扩展能力,装之前一定看清楚来源、权限,以及它会不会调外部 API、会不会读取或发送你的内容。
定时任务:让它主动找你
这一步我认为是整个产品里最关键的转折。
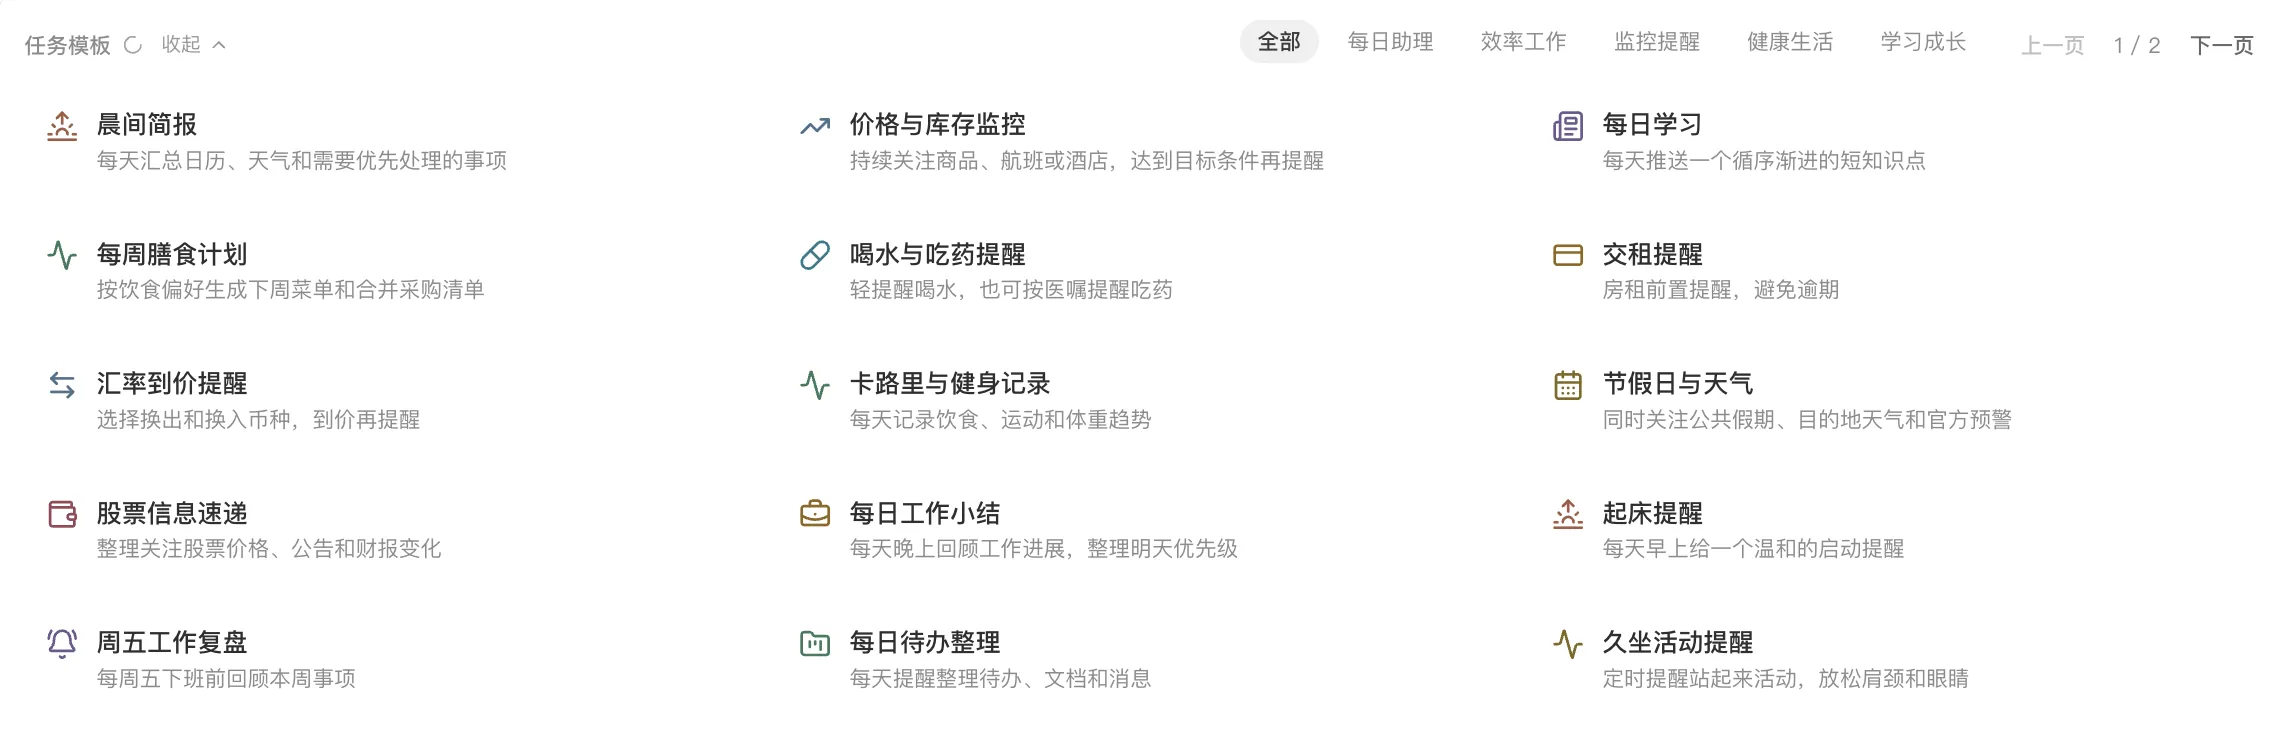
LightVela 的定时任务分三类,很多人没注意这个区别,白白烧掉一堆 Token:
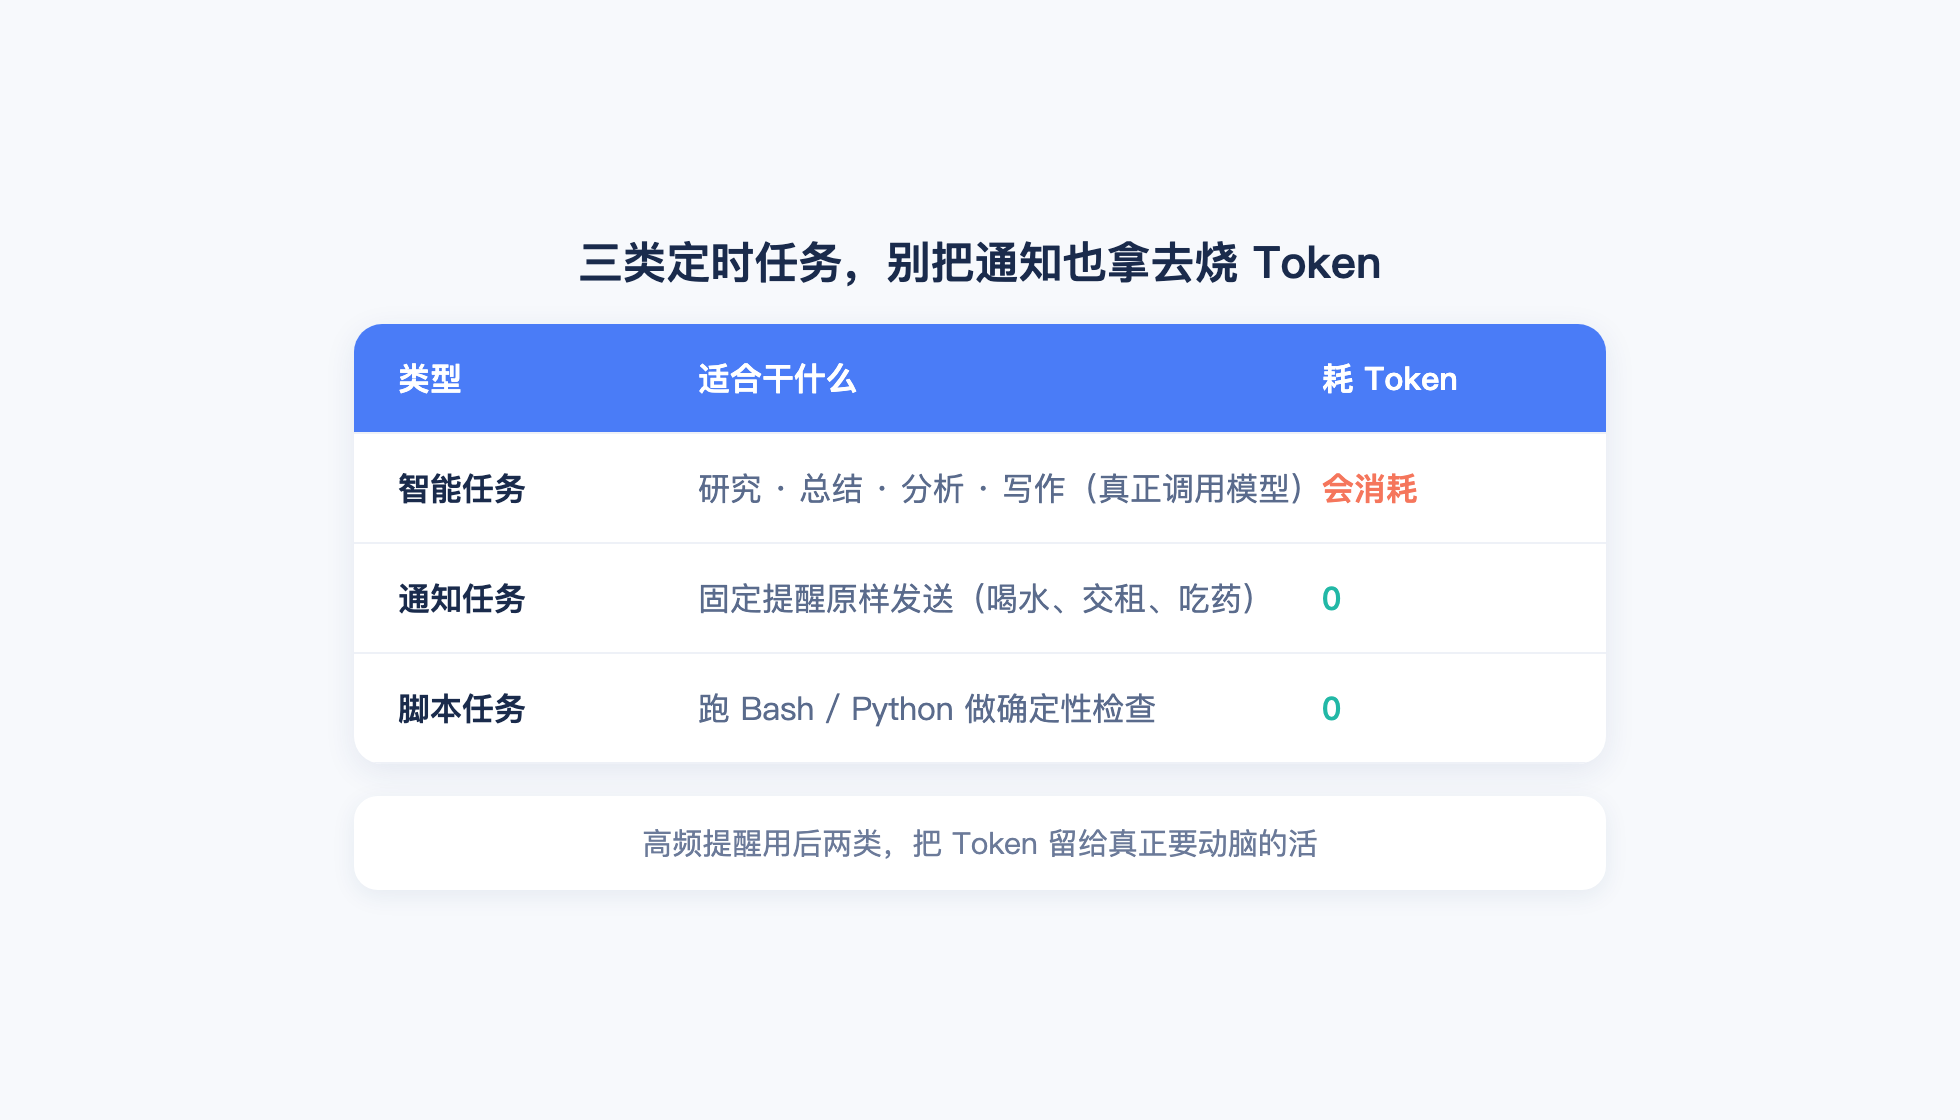
- 智能任务:真正调用 Hermes 和模型,适合研究、总结、分析、写作
- 通知任务:原样发送固定提醒,不调模型,比如喝水、交租、吃药
- 脚本任务:跑 Bash 或 Python 做确定性检查,也不调模型
后两类任务的模型 Token 消耗为 0。所以高频的机械提醒,别用智能任务去做。
举个例子,创建一个每天早上 8:30 的智能任务:
> 搜索过去 24 小时最重要的 AI 新闻。只选择真正影响 AI 产品、模型、Agent、算力和开发者生态的事件,过滤营销软文和重复报道。输出:1. 今日最重要的 5 条新闻;2. 每条为什么重要;3. 对普通 AI 用户有什么影响;4. 原始来源;5. 最后给出一个 100 字以内的趋势总结。完成后发送到我的微信。
从这一刻起,体验就变了。以前是「你打开 ChatGPT → 提问 → AI 回答」,现在是「Agent 一直在线 → 到点自己开工 → 做完主动把结果送到微信」。
这中间的差别,才是 Personal Agent 真正值得折腾的地方。
顺带一提,它还有个 Beta 状态的「工作台」,能靠对话创建和托管静态网站;Labs 里还有托管的 DeepSeek Harness 环境。这些建议等基础玩法跑熟了再碰。
新手照抄的闭环,和一条安全底线
如果你第一次用,别一上来就让它「帮我经营一家公司」。
先跑一个最简单的闭环,七步:
1. 创建 Hermes
2. 接进微信
3. 设置 Soul
4. 告诉它你的偏好
5. 安装浏览器 Skill
6. 创建每日 AI 简报任务
7. 第二天在微信里等它主动发结果
这一圈跑通,你就彻底明白 Personal Agent 和聊天机器人的区别了。然后再慢慢加项目资料、第二通道、更多 Skill 和云存储。
安全这件事,必须单独说。
Agent 越能做事,权限就越要盯紧。 LightVela 高级设置里有智能审批、始终询问、关闭审批等模式,选「关闭审批」意味着部分高风险操作不再向你请示。
刚开始折腾,我建议把原则定得保守一些:查资料可以主动做,整理和分析可以主动做;但涉及发送、删除、修改、付款、账号权限的动作,必须先问。
另外,API Key、AppSecret 这类凭证别发到群聊、公开网页或 Git 仓库。模型和通道的密钥一旦泄露,马上去对应服务商后台撤销或重置。
最后
回到开头那个问题:你想要的到底是一个更聪明的聊天框,还是一个能接着干活的东西?
如果是后者,那形态比模型参数重要得多——它得一直在、记得你、能动手、还能主动来找你。LightVela 给出的答案是:把 Agent 放云上,把入口放进你天天用的聊天软件,然后让你慢慢把它养成自己的。
最有意思的一点是,这件事不需要你准备服务器。创建一个 Hermes,接进微信,告诉它你是谁、希望它怎么做事,再慢慢加 Skill 和自动任务。
一个属于你的 AI Agent,就这么开始「养」起来了。
产品还在快速迭代,通道、套餐、模型、Skill 和 Beta 功能,都以实际控制台和官方最新文档为准。
今天就能做的一步:花五分钟创建一个 Hermes,把它接进微信,然后问它一句——「你现在对我有哪些了解?」
它会告诉你,它什么都还不知道。而这正是开始的地方。
适合谁:想把 AI 从聊天框变成长期助手的人、需要定时简报和资料整理的运营与研究者、不想折腾服务器和 Docker 的普通用户



