做电商图还在重写提示词?这不是创作,是重复劳动
同一件商品要出主图、场景图、海报三套图,你其实是在三个对话框里把同一段卖点重述三遍。GitHub 上这个不到两千 star 的开源项目把参考图、1,446 条提示词模板和十几个生图模型接进了 Claude Code、Cursor:先搜案例,再增强提示词,确认后才按下生成。真正的改变不是画质更好,是你不用再说一百遍同样的话。
一个做电商图的人,一晚上真正花掉的时间,大部分不在"出图"。
你有一件瑜伽背心要上新。主图要白底干净版,场景图要有个女生在窗边做拉伸,详情页还得有一张面料细节和一个配色清单版。四张图,听着不多,但你实际干的事情是:把同一个商品的卖点,在四个不同的对话框里重新描述四遍。背心的领口、腰带的位置、面料那个竖条纹肌理——每一次都要重讲一次,因为换个对话就什么都不记得了。
模型跑偏一次,你就把中间那段"主体保持不变、只改背景"的句式再调整一次。最后出图的那一刻你才发现,四张图里的背心是四个不完全一样的背心。
这件事有个更准确的说法:你不是在创作,你是在重复劳动。而重复劳动的解法从来不是更会写提示词,是别再重写了。
最近 GitHub 上有个东西在解决这个具体问题,不到两千 star,MIT 协议,叫 MeiGen AI Design MCP。它做的事用一句大白话讲:把参考图、提示词模板和生图模型接到同一个地方,让 AI 编程工具(Claude Code、Cursor、Codex、Windsurf 这些)直接变成你的设计助理。
真正值钱的不是它接了哪些模型,是它改变了你干活的顺序。
一、先搞清楚重复劳动到底重复在哪
把上面那个晚上拆开看,你会发现"重写提示词"这个动作里,其实混着三种不同的东西。
第一种是商品本体:什么版型、什么颜色、面料什么质感、logo 放哪。这部分每件商品只需要说一次,但你每次开新对话都得重说。
第二种是画风偏好:你店铺统一的调性是暖白自然光还是冷调高级灰,模特是真实感还是插画感。这部分理论上一年都不用改,但因为它只活在你的审美里,从来没被固化下来,所以每次都要"再描述一下那种感觉"。
第三种才是每次真正不同的东西:这一张是主图,那一张是场景图,还有一张是海报。
重复劳动的真相是:前两种占了你工作量的七成,但它们被第三种裹着一起,被迫反复重写。
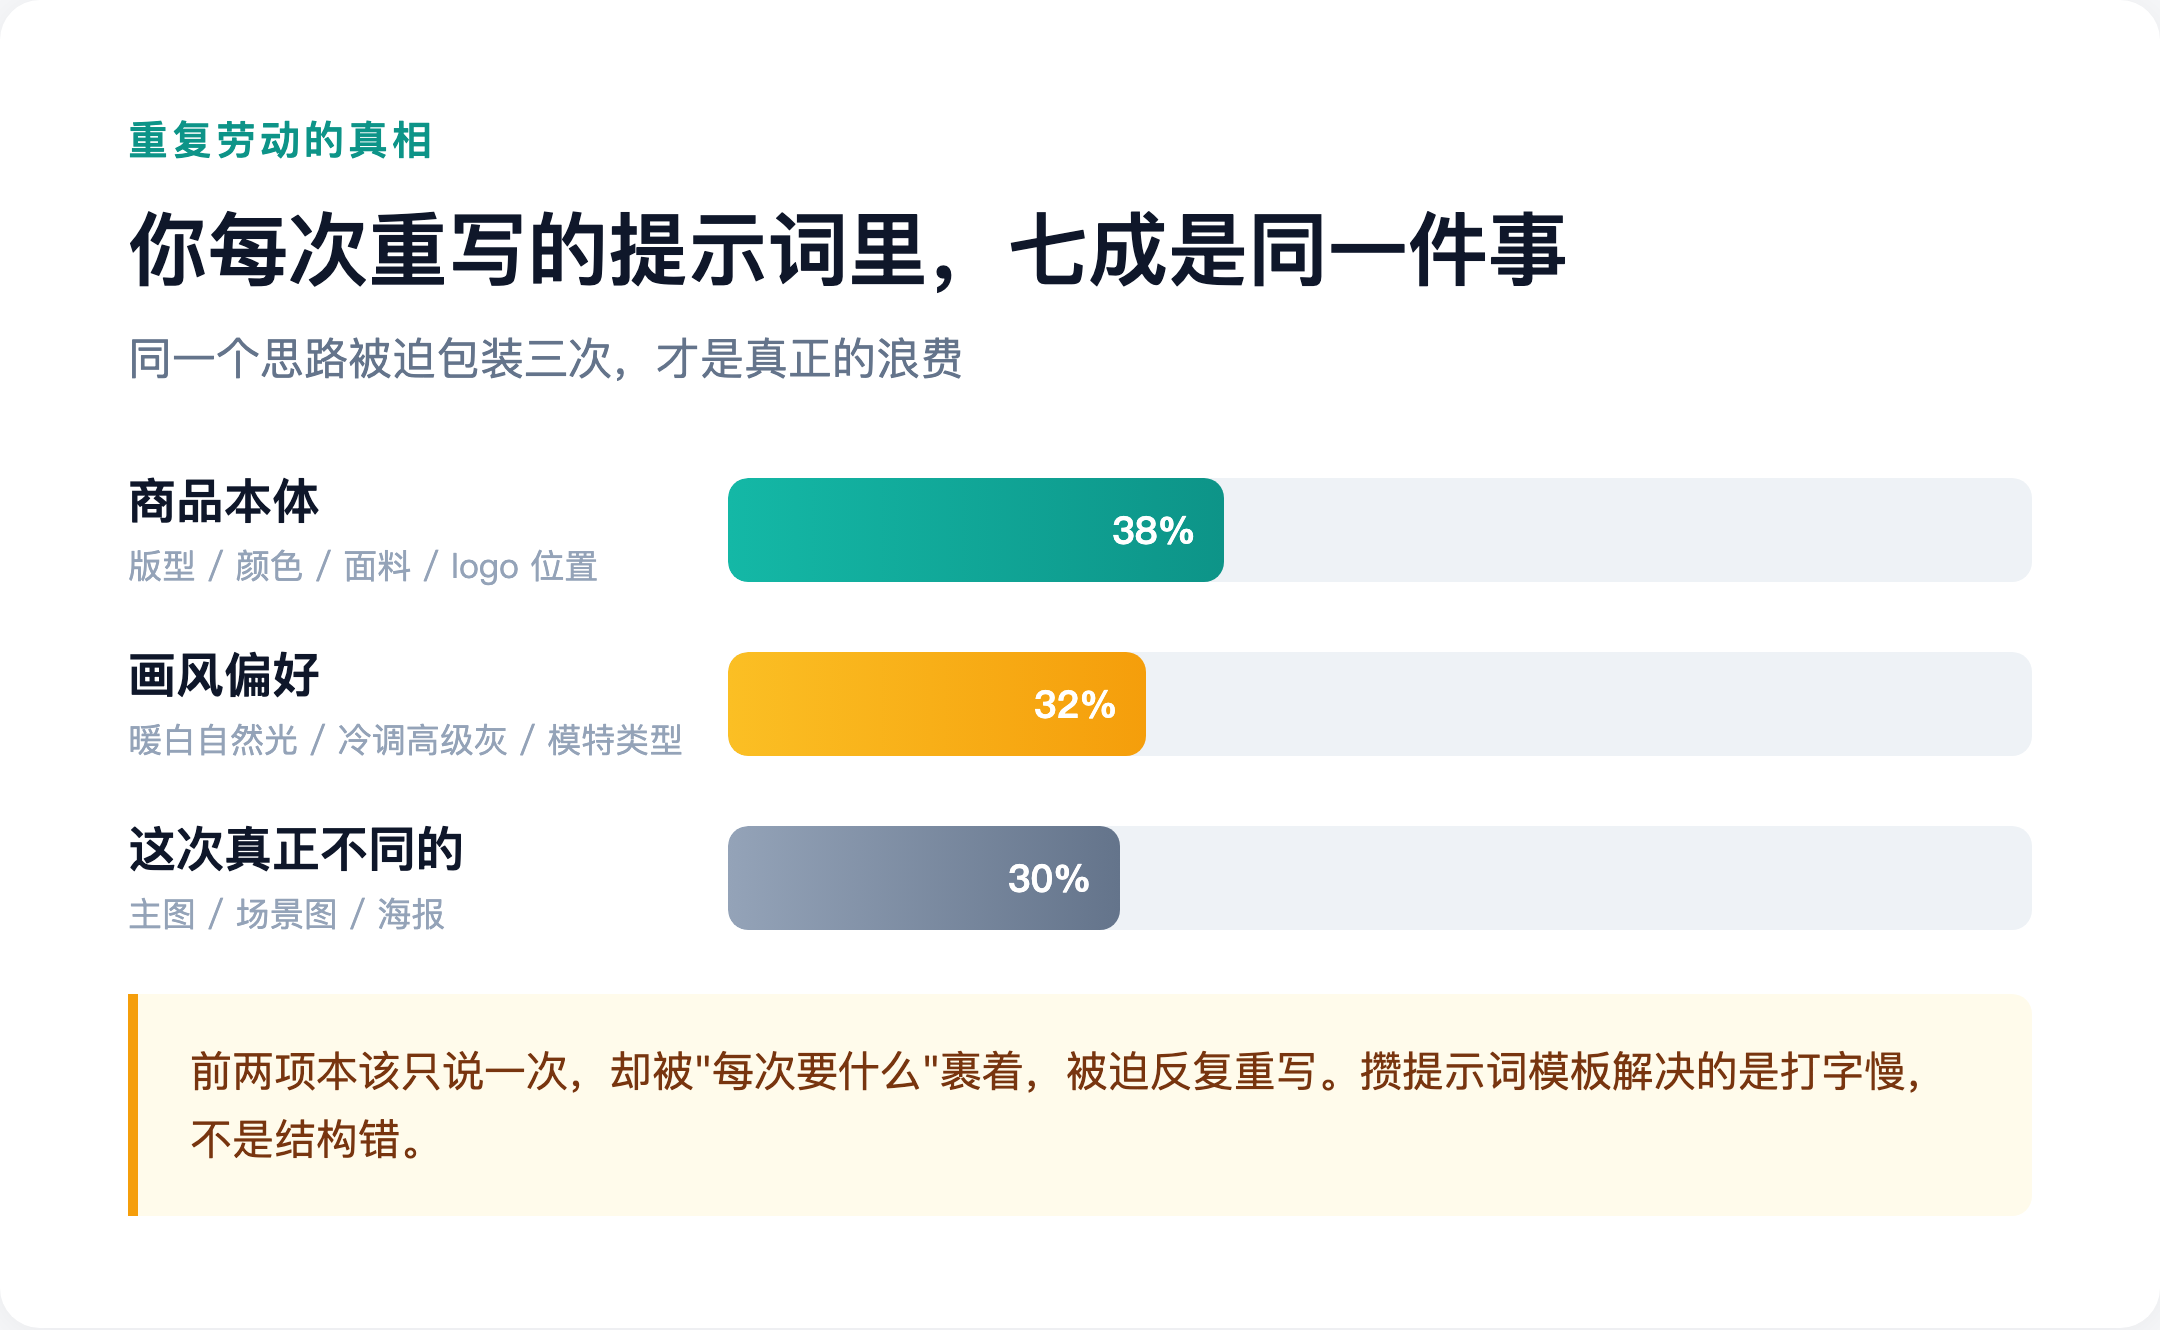
所以靠"多攒几个提示词模板"是治不好的。提示词合集解决的是打字慢,不是结构错。要解决结构问题,得让这三样东西各自有个固定的存身之处——商品描述是持久的,风格偏好是持久的,只有"这次要什么"是每次输入的。
MCP(Model Context Protocol)这个词听着吓人,它在做的事就是这个:给外部工具一个标准的接口,让 AI 编程助手能稳定地调用它,而不是每次都在对话框里靠自然语言描述一遍。
二、它接进来的不是模型,是上下文
MeiGen 这个服务挂上之后,你的 AI 编程工具里多了十几个可用能力。别被"十几个"吓到,日常真正用得上的就三个:
`search_gallery`——翻灵感库。 里面躺着 1,446 条整理过的提示词模板,每条都带预览图。你不用凭空想"高级感怎么描述",直接搜,看到接近的方向,拿来改。
`enhance_prompt`——把大白话变成模型听得懂的话。 你说"窗户旁边一个女生做拉伸",它给你补成光线角度、镜头焦段、构图比例、模特状态都写清楚的完整描述。
`generate_image`——出图。 可以指定模型、指定比例,还能带一张本地参考图进去。
重点是这三步可以连着走,而且中间的产物是持久的——搜到的模板能存进收藏,你偏好的风格、常用比例、惯用模型能存进偏好设置。这就是为什么它跟你自己在对话框里打字不一样:你每次重开对话是从零开始,它是从你上次的地方接着往下。
顺带说一句,前两个能力不需要任何 API key,免费的。也就是说哪怕你暂时不想花钱生图,把它接上当个"灵感检索 + 提示词润色"的工具也值。
三、顺序比工具重要:先搜,再增强,最后生成
大部分人用 AI 生图的顺序是错的。
常见顺序是:脑子里想到一个画面 → 直接写提示词 → 出图 → 不满意 → 改提示词 → 再出图。这个循环里,你每一轮都在赌,赌自己这版描述能把那个看不见的画面说清楚。赌输了就再来一轮,三轮下来人就烦了。
MeiGen 强制的顺序是:先翻模板看别人怎么做的,选定方向,把你的大白话喂进去增强成完整提示词,你确认之后再按下生成。
差别在哪?
第一步"搜",是把抽象意图变成具象参照。你说"高级感"是没用的,但你指着第三排第二张说"就这个调子,换成我的商品",这件事瞬间就具体了。
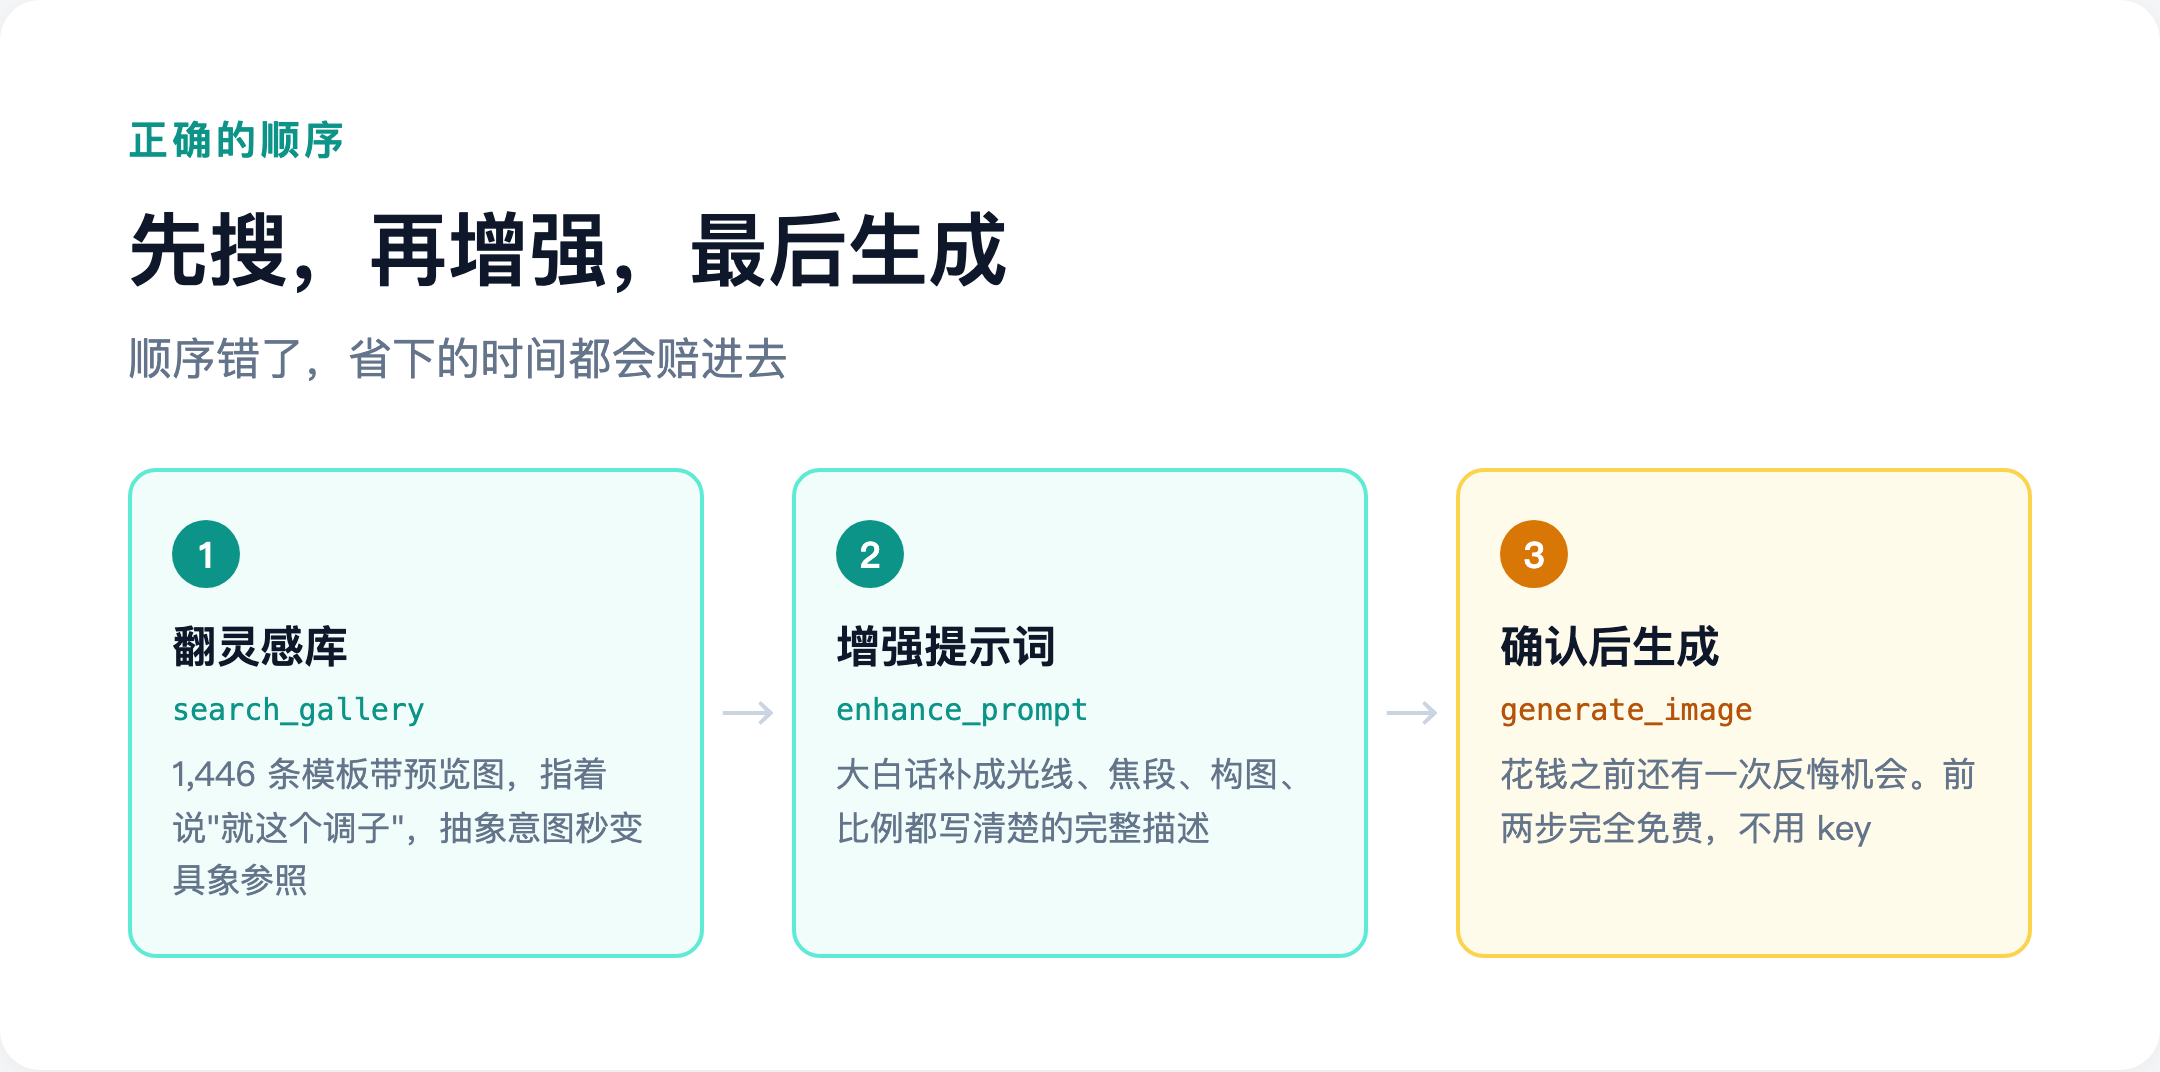
第二步"增强",是把具象参照翻译成模型能执行的参数。这一步模型比你强,因为它知道哪些词对哪些模型有效。
第三步"确认后生成",是把钱花在刀刃上。这一步最关键——它让你在花钱之前还有一次反悔的机会。电商跑图是按张计费的,一次并行跑四张就是四张的钱,生成前多看一眼提示词,省的是真金白银。
很多人的习惯是"一把梭先生成看看",在单价几分钱的时候这个习惯无所谓,一旦你跑的是 Midjourney 或者视频模型,这就是纯粹的浪费。
四、模型不是越多越好,是要知道什么时候换
它支持 11 个模型入口,你常听到的那些基本都在:GPT Image 2、Nano Banana 2、Seedream 5.0、Midjourney V8.1、Flux 2 Klein、Grok Imagine,视频那边有 Seedance 2.0、Veo 3.1、Grok Video,再加上本地 ComfyUI。
面对一堆选项,实用主义的分法是这样的:
打草稿用便宜的。 方向还没定的时候,用单价低的模型快速铺开四五个方向,看哪个顺眼。这时候追求的是数量和速度。
定稿用好的。 方向定了,要出最终上详情页的图,换贵的模型重跑一次,追求的是质感和细节一致。
批量用统一的。 同一个系列要出十张图,就锁死同一个模型同一个种子设置,别中途换——换了模型,十张图的皮肤质感和色彩倾向会漂,拼在一起比单张难看得多。
至于视频,说句实话:视频生成的等待时间是 5 到 15 分钟这个量级,所以它不适合"边聊边调"的工作方式。更合理的用法是先把静态画面搞定,确认满意了,再拿这张静态图当首帧去跑视频。别直接跳进去撸视频,那是在用最贵的方式做试错。
五、5 类 Skill,正好对上电商图的五个工位
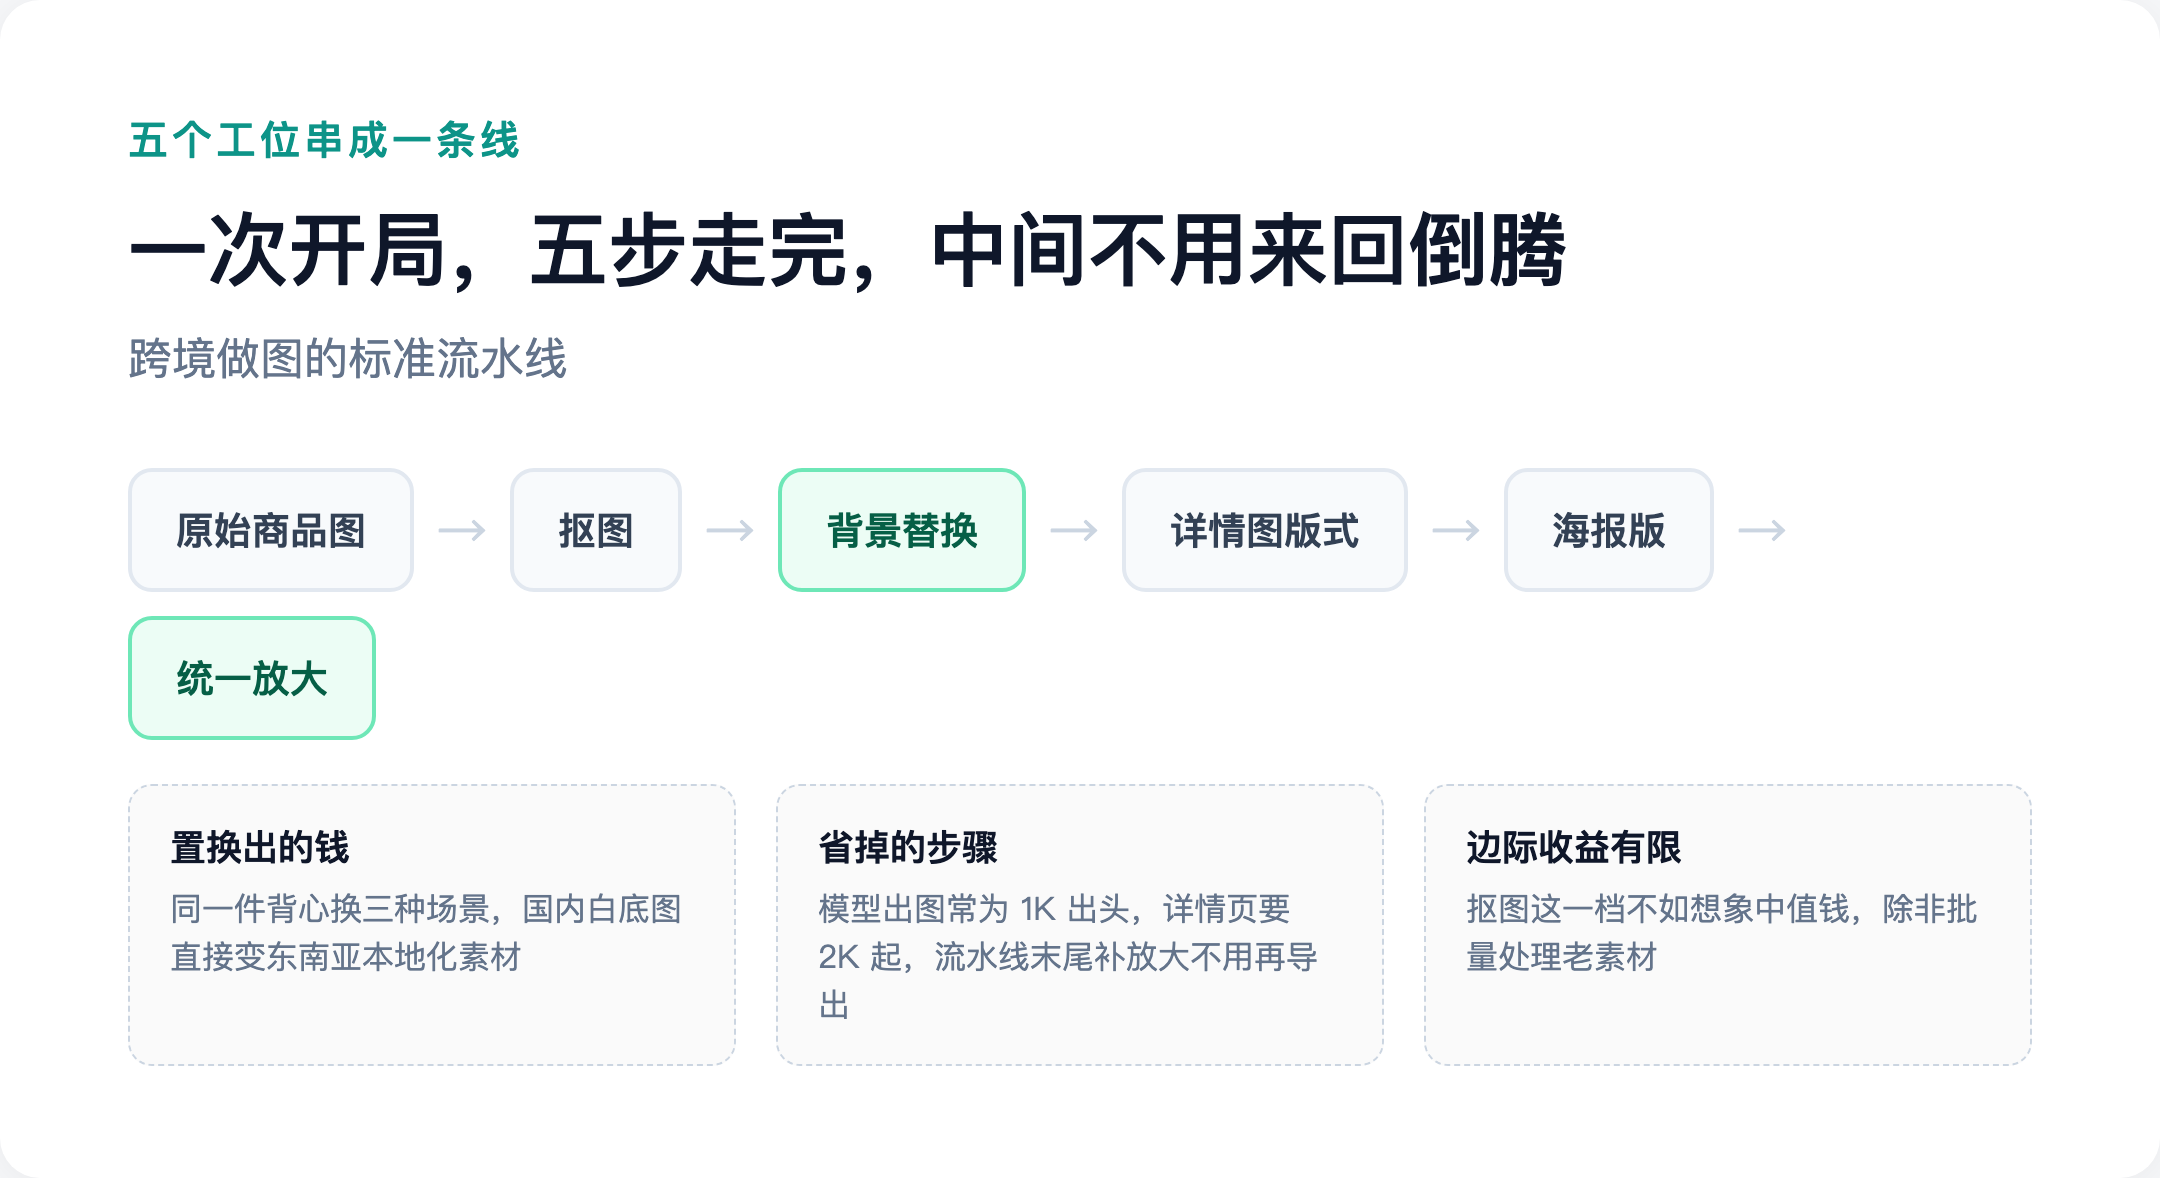
电商做图其实是有标准工位的,MeiGen 提供的 5 类视觉 Skill 恰好按这个划分:抠图、详情图、海报、背景、放大。
这五个里,真正省时间的是后两个。
背景替换是跨境卖家的日常。国内拍好的白底图,换个东南亚风格的场景就能当本地化素材发;同一件背心,白天榻榻米、傍晚落地窗、户外草地,三种氛围对应三种投放人群。过去这个活要在 PS 里抠、合成、调光影,现在是一句话加一张原图。
放大则解决另一个具体的痛:模型出图常常只有 1K 出头,详情页要求 2K 起,以前要么忍着模糊上传,要么再导出到别的放大工具里倒一手。现在这条流水线里能直接补一步。
抠图的价值不如想象中大——现在主流模型的抠图已经很干净了,专门调一个 Skill 出来的边际收益有限,除非你批量处理老素材。
真正会改变工作方式的其实是"这五步能串成一条线":拿原始商品图进来,抠图 → 换背景 → 生成详情版式 → 补海报版 → 最后统一放大输出。一次开局,五步走完,中间不用下载再上传。
六、并行:主图、场景图、海报同时跑
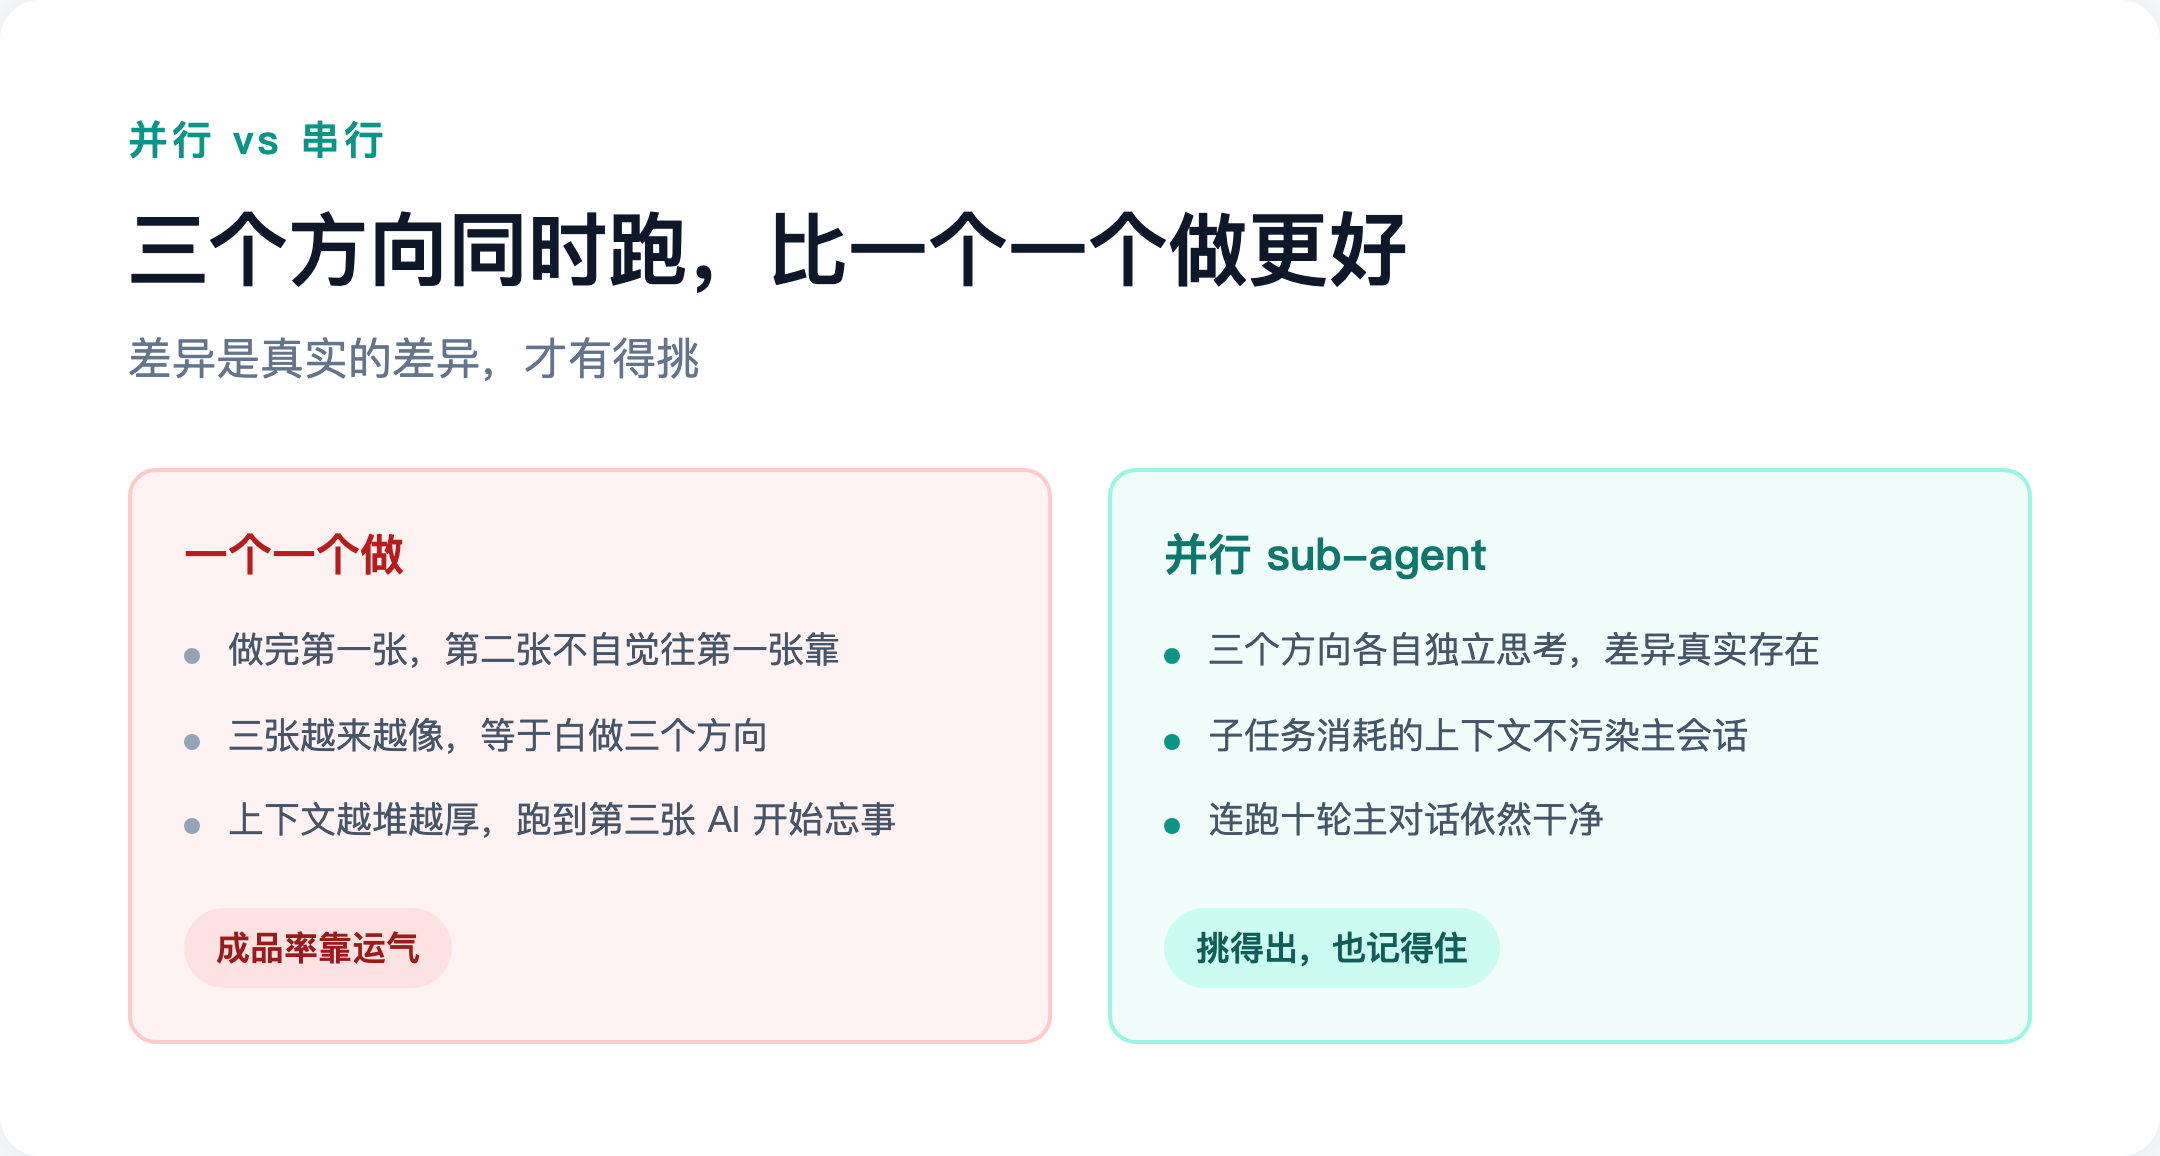
这是我觉得最被低估的一点。
它内部用了个子代理并行的机制:你下一个"给这件商品出主图、场景图、海报"的指令,它会拆成几个独立子任务同时跑,每个子任务自己去想自己的提示词,最后把几张结果一起交回来。
为什么这很重要?两个原因。
第一,并行的产出比串行的一致性更好。听起来反直觉,但事实如此:串行做的时候,你做完第一张会不自觉地让第二张往第一张靠,最后三张图越来越像,等于白做了三个方向。并行的时候三个方向各自独立想,差异是真实存在的差异,你才有得挑。
第二,主对话的上下文是干净的。这是个技术设计上的聪明地方:子任务消耗的上下文不污染主会话。你连续跑十轮也不至于让主对话臃肿到开始遗忘前面的要求——这是很多人用 AI 跑批量任务的隐性瓶颈,跑着跑着 AI 就开始忘事,你还以为是模型变笨了。
七、别急着把整店素材接进去
这条是我自己最想强调的,也是最容易犯的错。
看到这种工具,第一反应往往是"太好了,我把店铺里三百个 SKU 全导进去批量跑一遍"。别这么干。
正确的起手式是:先挑一件商品,跑三个方向。
为什么是"一件"?
因为你要在最小成本下验证三件事——这个工作流在你手上通不通;生成的图能不能直接用,还是还要返工;以及最关键的,你的商品要不要加特定的描述约束(比如你卖的功能性面料必须保持肌理一致,你家模特必须是特定体型)。这些约束是在实践中一条条长出来的,不是一开始就能想全的。
为什么是"三个方向"而不是一个?
因为一个方向无法比较。你只有跑出主图、场景图、海报三张,才知道这套东西在你的品类上,哪个方向的成品率最高。成品率这个概念很重要:不是"能不能生成",而是"生成的十张里有几张能直接上线"。
拿一件商品跑通之后,把有效的提示词存进收藏,把验证过的风格和比例存进偏好。这时候你的工作流才算立住了,再往第二件、第十件扩,扩的速度会快得不像话——因为第一件付出的所有试错成本,后面每一件都在白嫖。
先打通一个,再复制一百个。反过来做,你会死在第 17 个 SKU 上,而且到那时候你已经攒了一堆没法返工的半吊子图。
八、三种后端,其实是三种取舍
它可以跑在三个地方,选哪个不是技术问题,是你要什么的问题。
云端模式:最省事,注册拿个 token 就能跑,九种图片视频模型都能用。代价是每张图都要花钱,而且你的参考图要上传到别人的服务器。
OpenAI 兼容模式:你自己有 key 有自己的接口,填进去就行。适合已经有稳定供应商、或者有公司内部接口的团队。
本地 ComfyUI 模式:完全离线,跑在你自己的显卡上,数据不出本机,也不要钱。代价是你要先装好 ComfyUI 和对应工作流,而且一次只能处理一个任务,批量会慢。
对跨境卖家来说,这个选择其实有个明确答案:涉及未发布的新品、或者有品牌保密需求的素材,走本地;日常批量跑常规款,走云端。两种同时配着也没问题,它是支持切换的。
九、泼几盆冷水
不是什么场景都适合。
成本会失控。 它没有内置的预算上限和速率限制。你要是写个脚本让它自动跑一百张,一百张的钱就真花出去了。并行很爽,但每次按下生成前,你得知道自己按下去意味着多少钱。建议一开始就给自己定个规矩:批量脚本里写死最大并发数和单次总数。
商用授权要自己查清楚。 项目文档里没有明确说明大规模商用和二次分发的授权边界,这部分取决于你用的那个模型的条款。TikTok Shop 和亚马逊对图片原创性是有要求的,别想当然认为"AI 生成的就能随便用"。
实时视频别指望。 前面说了,几分钟的量级,这东西跟实时编辑不是一回事。
别把它当成设计师的替代品。 它替的是"把已知意图翻译成图"这个环节,不替"想出一个好创意"。你的方向感、你对自家店铺调性的理解、你知道你家客户吃哪一套——这些它给不了。它给的是把你的判断快速铺开成十张图的能力。
十、如果你的团队现在就要上,照这个顺序走
给一个可以直接抄的执行清单:
第一天:把它装到你最常用的那个 AI 编程工具上,先什么都不配,只用免费功能——搜灵感、增强提示词。花半小时把 1,446 条里的同类目翻一遍,感受一下你品类的常见视觉套路。
第二天:配一个后端。建议先从 OpenAI 兼容或者本地 ComfyUI 起步,成本可控、心理负担小。确认跑得通再考虑云端。
第三天:挑一件商品,跑三个方向。验收标准不是"好不好看",是成品率——十张里有几张能直接传后台。如果成品率低于三成,说明你的商品描述约束没写够,回去补,不要急着往下走。
第四天及以后:把跑通的存成偏好,开始扩 SKU,同时脚本化。它提供独立 CLI,可以进 CI/CD,批量活在命令行里跑更稳。
最后说句可能不太客气的话。
这两年大家讨论 AI 生图,话题永远围着"哪个模型更强""谁的画质更真"。但对一个真的要上新的人来说,模型强弱早就过了那条线——2026 年还在纠结模型画得好不好,就像 2010 年纠结相机像素。
真正卡住你的是另一件事:同样的话你要说一百遍,同样的风格你要重描述一百次,同样的工作流你要手动重搭一百次。
把这件事解决掉的模型,才是你应该关注的那个。
适合谁:每天要出多套电商图的跨境卖家、想把生图流程脚本化的设计团队、受够了在对话框里反复重述需求的人



