Postman 强制登录加云同步烦透了?Bruno 把 API 请求存成纯文本进 Git
每个请求就是一个 .bru 文本文件,放在你的代码仓库里,天然进版本控制、能 code review、能跑进 CI。这篇讲它的工作机制和最适合哪类团队。
Postman 把你的 API 请求存在云端,强制登录才能用,团队协作要付费。这些变化让一部分开发者很不舒服——尤其是那些把"API 请求"视为代码资产、理应和项目放在一起的人。
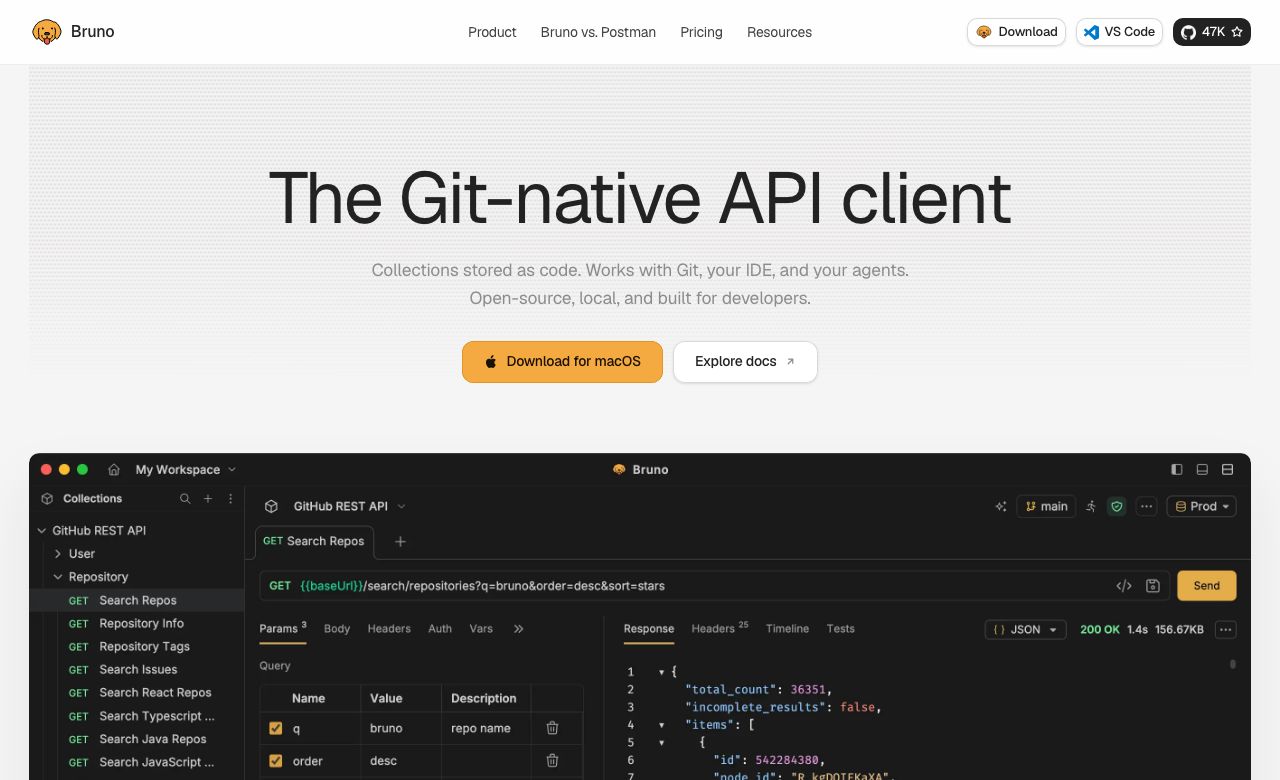
Bruno 就是为这批人做的。它在 GitHub 上有 4.7 万 star,MIT 协议。它的核心主张只有一个:API 请求应该以纯文本文件的形式,存在你自己的项目仓库里。
它到底是什么
Bruno 是一个 API 测试客户端,但它的存储方式和同类工具完全不同。
你的每一个请求,都是项目目录里的一个 .bru 文件,内容是纯文本:
meta {
name: Get User
type: http
seq: 1
}
get {
url: {{baseUrl}}/users/{{userId}}
body: none
auth: none
}
headers {
Content-Type: application/json
}
这个文件就在你的代码仓库里,和 src/ 平级。这带来几个直接的好处:
- 天然进 Git:请求变更有 diff、有 code review、能回滚
- 不依赖云端:没网也能用,没有账号系统
- 和代码同步演进:后端改了接口,改请求文件的 PR 和改代码的 PR 一起提
- 不会丢失:不像存在某个客户端本地的数据,重装系统就没了
这个设计思路其实很经典——把数据变成纯文本,就能复用整个版本控制的生态。Git 之所以强大,就是因为它管的是文本。
它怎么工作
Bruno 是一个桌面应用(也刚出了 CLI),打开你的项目目录,就能看到所有请求文件。
关键机制:
- 环境变量:存在
environments/目录,同样进 Git(敏感值可以设成 secret,不提交) - 集合:就是目录结构,文件夹即分组
- 脚本:请求前后可以跑 JS,做签名、断言、变量提取
- CLI 运行:官方的
bru命令行工具可以直接跑集合,天然适合集成进 CI
最后一条很重要:因为是纯文本文件,你可以用 bru run 在 CI 里跑接口测试,不需要任何云端账号或服务。这对把接口测试纳入自动化流水线的团队非常友好。
和 Postman、Hoppscotch 的区别
三者定位其实有清晰差异:
- 存储:Bruno 本地纯文本(进 Git);Postman 云端账号;Hoppscotch 浏览器/自托管
- 离线:Bruno 完全离线;Postman 需登录;Hoppscotch 网页版可离线用
- 协作:Bruno 靠 Git;Postman 靠云端团队空间;Hoppscotch 靠分享链接/自托管
- 上手门槛:Bruno 略高(要理解文件结构);Postman 低;Hoppscotch 最低
选哪个,取决于你把 API 请求当成什么:
- 当成代码资产,要评审、要版本管理 → Bruno
- 当成团队共享文档,要方便非技术同学查看 → Postman
- 当成临时调试工具,随手发个请求 → Hoppscotch
上手要注意的三件事
敏感信息别提交。 .bru 文件进 Git 意味着里面的内容都会进仓库历史。Token、密码这类必须放在 secret 变量里,Bruno 支持标记为 secret,不会写入文件。另外建议配 .gitignore 把本地环境变量文件排除掉。
团队要约定目录结构。 文件在仓库里,如果没有规范,很快会乱成一团。提前约定:按服务分目录、按环境分文件、请求命名规范。
CLI 版本要和桌面版对齐。 桌面版和 CLI 的 .bru 格式版本可能不一致,CI 里跑失败时先检查版本是否匹配。
什么团队最适合
- 后端团队希望接口测试和代码在同一个 PR 里评审
- 有合规要求、API 数据不能出内网的
- 受够了"Postman 集合导出导入、版本对不上"的
- 想把接口测试跑进 CI 的
反过来,如果你的团队里有大量非技术同学要查看和调用接口,纯文本文件的门槛会让人不适应——这种情况下 Postman 的图形界面还是更友好。
把 Bruno 用好的四个习惯
目录结构提前定规范。 建议按"服务 / 模块"两级组织,请求文件用动词开头命名(get-user、create-order)。团队统一了,仓库里几百个请求文件才不会失控。
环境变量分层。 全局环境(baseUrl 这类)放 environments/global.bru,环境相关的(dev/staging/prod)分文件放。敏感值用 secret 类型,不进 Git。
把断言写进测试脚本。 每个请求后面加一段简单的断言(状态码、关键字段),这样 bru run 在 CI 里就是真正的接口测试,而不只是"能发通"。
test("返回 200", function() {
expect(res.getStatus()).to.equal(200);
});
CI 里跑冒烟,别跑全量。 全量接口测试跑起来慢,而且容易因为无关的环境抖动失败。CI 里只跑核心链路的冒烟测试,全量留到发布前手动跑。
迁移 Postman 的成本
Bruno 支持直接导入 Postman 的集合(导出成 JSON 后导入)。这一步通常很顺利,但有两个常见的不兼容点:
1. Postman 的某些预请求脚本写法在 Bruno 里需要微调(API 名称不同)
2. Postman 的复杂变量作用域,迁移后要重新梳理到 Bruno 的环境变量体系里
对中小型集合,迁移通常半小时内能搞定。集合特别大(几百个请求)的,建议分批迁,先迁最常用的那部分。
一个真实的使用场景
后端改了一个接口的字段,前端同学的 Postman 集合里还是旧参数,跑出来一堆错。这类"接口变更了但请求定义没跟上"的问题,几乎每个团队都遇到过。
用 Bruno 之后,这个流程变成:后端改代码的同时,在同一个 PR 里改 .bru 文件。评审的人能看到"接口改了什么字段、请求示例同步更新了",测试和前端同学拉下代码就拿到了最新的请求定义。
这解决的不只是"请求会不会过时",更是让接口契约变得显式、可评审、可追溯。很多前后端联调的低级摩擦,根源就是契约只存在于某人的 Postman 里,没有进入版本控制。
如果你的团队正被这类问题困扰,Bruno 的价值会立刻体现出来。
我的看法
Bruno 代表了一种很朴素的工程价值观:能用文本文件解决的,就不要用数据库和账号系统。
API 请求本质上是配置,而配置最成熟的载体就是版本控制里的文本文件。Bruno 只是把这个显而易见的道理做成了产品。它不一定适合所有人,但如果你认同"接口定义应该和代码一起演进",它几乎是当前最好的选择。
官方仓库在 github.com/usebruno/bruno。
适合谁:把 API 请求当代码资产管理的后端团队、有数据不出内网要求的、想把接口测试纳入 CI 的