服务挂了还是客户先发现?用 Uptime Kuma 五分钟搭一个自托管监控面板
一条 Docker 命令就能装上,自带公开状态页和几十种告警渠道。这篇讲清楚它和 Prometheus 的分工(黑盒 vs 白盒),以及为什么小团队应该先上它。
服务挂了两个小时,你是第一个知道的——因为客户在群里 @ 你。这种事发生过一次,你就知道监控不是"有了更好",而是必须有。
商业监控服务能解决问题,但要按探针数量、按检查频率收费,而且你的服务地址、响应时间这些数据都存在别人那里。Uptime Kuma 提供的是另一条路:自己搭一个,全部数据留在自己机器上。
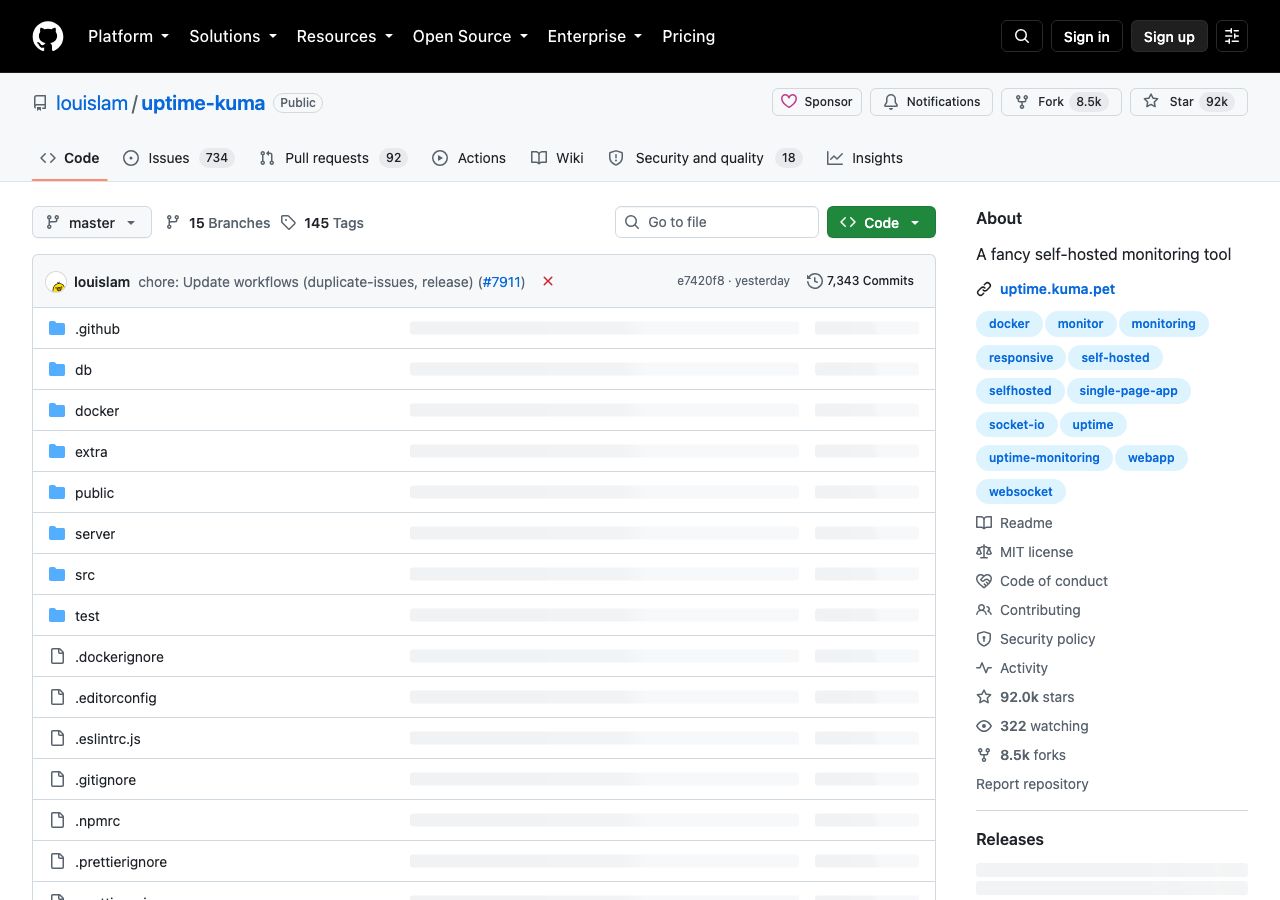
它在 GitHub 上有 9.2 万 star(自托管监控领域几乎是第一名),MIT 协议,商用没问题。
它到底是什么
Uptime Kuma 是一个自托管的监控工具。它的核心功能很朴素:定期检查你的服务还在不在,不在了就通知你。
听起来简单,但它的完成度相当高。支持的监控类型远超"网站能不能打开":
- HTTP(s) 站点可用性
- TCP 端口
- Ping(ICMP)
- DNS 记录
- Docker 容器状态
- 关键词检测(页面里是否包含某段文字)
- 游戏服务器、Steam 服务等一堆特定类型
告警渠道也铺得很全:Telegram、Discord、Slack、邮件、Webhook、飞书、钉钉,还有几十种通知服务。国内常用的渠道基本都覆盖了。
五分钟装好
最省事的方式是 Docker,一条命令:
docker run -d --restart=always -p 3001:3001 \
-v uptime-kuma:/app/data --name uptime-kuma louislam/uptime-kuma:1
打开 3001 端口,创建管理员账号,就能用了。加一个监控项只需要填 URL 和检查间隔,一分钟不到。
有个提醒:装完第一件事是设置好管理员账号和密码。它的默认状态是完全开放的,放到公网上不加防护等于把监控面板送给别人看。
三个容易被低估的功能
状态页(Status Page)。 这是 Uptime Kuma 做得特别好的一块。你可以生成一个公开的状态页,展示所有服务的可用性,还能自定义域名和 Logo。如果你的产品有外部用户,这个功能能让"服务是不是挂了"这件事变得透明,减少客服压力。搭配历史故障记录,还能展示过去 90 天的可用率。
维护窗口。 你要主动重启服务做升级时,可以设置维护窗口,这段时间内的告警会被抑制。没有这个功能,每次计划内维护都会收到一堆误报告警,久了你就开始忽略告警——那才是最危险的状态。
反向代理监控 + 证书过期检查。 可以监控 SSL 证书的到期时间,提前通知你续期。证书过期导致的服务中断是很常见的事故,而且往往是在最不合适的时候发生。
和 Prometheus + Grafana 怎么选
这是个常被问的问题。两者不是替代关系,是不同层级:
- Uptime Kuma 管的是"活着没"——黑盒监控,从外面看你的服务通不通
- Prometheus + Grafana 管的是"健康不健康"——白盒监控,CPU、内存、请求延迟、错误率这些内部指标
小团队和个人项目的务实做法:先上 Uptime Kuma。因为它五分钟就能装好、立刻有告警,解决的是"服务挂了没人知道"这个最痛的问题。等业务真的需要看内部指标了,再上 Prometheus。
反过来,一上来就搞 Prometheus + Grafana + Alertmanager 全家桶,配置成本高,很多人配到一半就放弃了,最后什么监控都没有。
上手的几个建议
检查间隔别设太短。 大部分业务 60 秒一次足够了。设成 10 秒,既增加自己服务器负担,也容易被对方当成攻击。
告警要去敏。 刚开始监控时容易设一堆告警渠道,结果每次抖动都被轰炸,最后你把通知全关了。建议:核心服务挂了立刻通知,次要服务连续失败 3 次才通知。
监控服务本身要异地。 如果你的监控和被监控的服务在同一台机器上,机器一挂,监控也挂了,你什么都收不到。至少保证监控部署在不同的机器或者不同的网络环境。
定期演练。 配完告警,手动停一次服务,确认告警真的能发出来、你能收到。很多人的告警配了半年,第一次真出事才发现渠道早就失效了。
让告警真正有用的四个设置
分级告警。 核心服务连续失败 1 次就通知;次要服务连续失败 3 次再通知。全部设成"失败就告警",结果就是告警疲劳,最后你把所有通知都关掉——那还不如不监控。
告警内容要带上下文。 别只发"服务挂了"。带上服务名、失败次数、最后一次响应时间、状态页链接。半夜收到告警时,你需要立刻判断要不要爬起来处理,信息不全就得自己登上去查。
设置恢复通知。 服务恢复了也要通知一声。否则你会一直处于"是不是还没好"的不确定状态。
定期测试告警链路。 每季度手动停一次非关键服务,确认告警真的能到你手上。通知渠道(尤其是 webhook 类的)会因为对方接口变更而失效,而这种失效是静默的。
资源占用与扩展
Uptime Kuma 本身非常轻,一个 1 核 1G 的机器跑几十个监控项毫无压力,SQLite 也够用。
监控项超过 100 个、或者检查频率很高时,建议换成 MariaDB/MySQL 后端,并且把历史数据保留期设短一些(默认会保存所有心跳记录,时间长了表会很大)。
如果要在多台机器上做冗余监控(避免单点),可以部署两个实例互相监控,但要注意告警去重——否则每次故障你会收到两份通知。
一个最小可行的起步配置
不要一上来就监控所有东西。建议按这个顺序来:
第一批(必须监控):对外服务的首页和核心 API、数据库端口。这三项挂了直接影响用户,告警设成"失败即通知"。
第二批(重要):后台任务队列、对象存储、第三方依赖的关键接口。这些挂了用户暂时感知不到,但会影响功能,设成"连续失败 3 次通知"。
第三批(锦上添花):内部管理后台、文档站、测试环境。这些可以用较长的检查间隔,告警甚至可以只发到群里不单独通知人。
按这个节奏,第一天你只配三五个监控项,十分钟就能配完并验证告警能收到。之后有需要再加,比一次性配几十项然后被告警淹没要健康得多。
值得吗
如果你有任何一个"挂了会影响别人"的服务在跑,答案是肯定的。它的安装成本是五分钟和一条 Docker 命令,换来的是"服务挂了你能第一时间知道,而不是等客户来告诉你"。
这个投入产出比,在运维工具里算得上最划算的那一档。
官方仓库在 github.com/louislam/uptime-kuma。
适合谁:所有有线上服务在跑的人、不想把服务数据交给第三方监控的团队、需要对外透明状态页的产品