拖节点搭 AI Agent 工作流:Sim 把 Agent 开发变成了画流程图
搭 Agent 真正难的不是调模型,是把模型、工具、记忆、分支串起来的胶水代码。这篇讲可视化画布为什么特别适合 Agent 开发,以及自托管要注意什么。
搭一个能用的 AI Agent,真正的难点从来不是"调大模型",而是把一堆东西串起来:调哪个模型、接什么工具、中间结果怎么存、失败了怎么重试、多轮对话怎么保持记忆。这些胶水代码写起来又琐碎又容易错。
Sim 这个项目给出的答案是:把这些都变成画布上的节点,你连线,不用写胶水。它在 GitHub 上有近 3 万 star,Apache-2.0 协议,可商用。官方定位是"构建、部署和监控 AI Agent 与工作流的协作工作区"。
它到底是什么
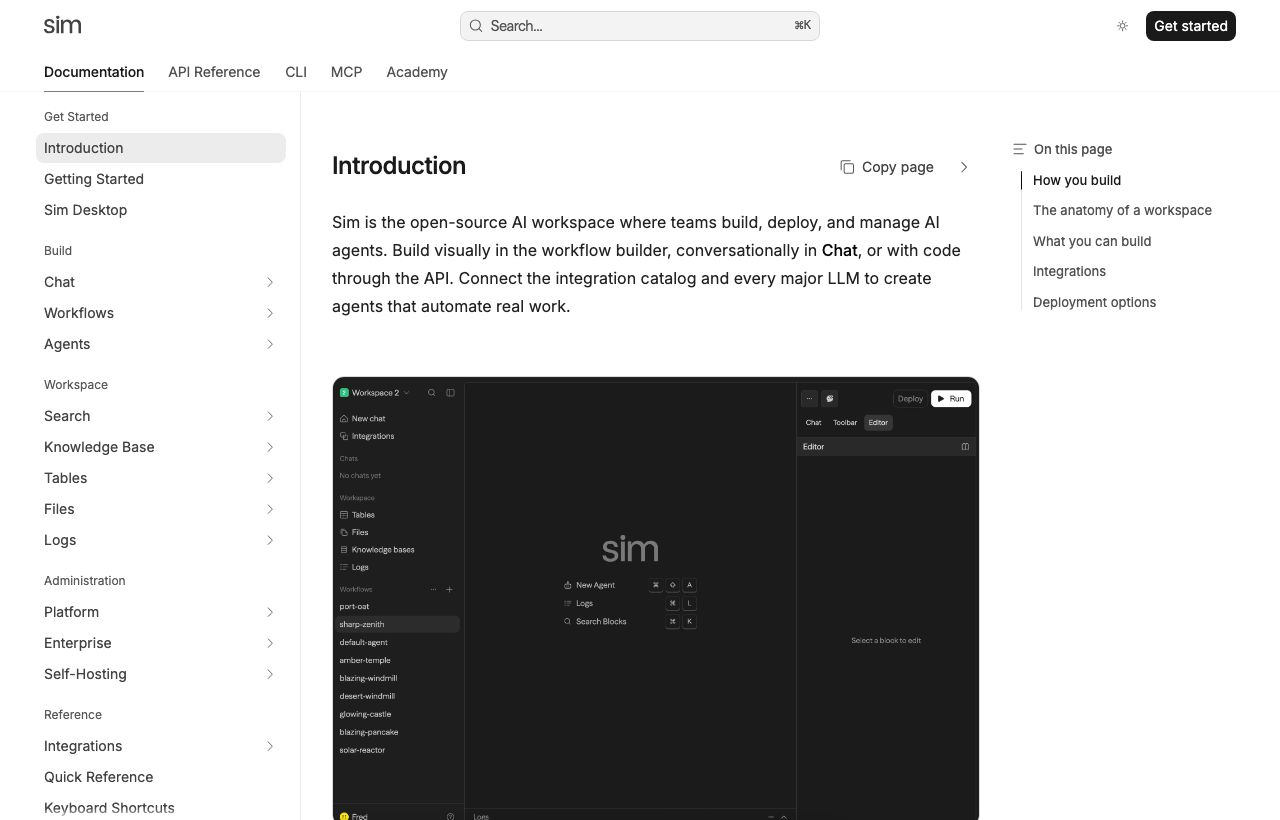
Sim 是一个可视化的 AI Agent 工作流构建平台,可以自托管,也有云服务。
它的交互模型和你用过的 n8n、Dify 是一类:画布上拖节点,节点之间连线,每个节点负责一件事。但 Sim 的侧重点是"AI Agent"而不是通用自动化——它的节点类型围绕模型调用、工具使用、记忆、条件分支来设计。
一个典型的工作流大概是这些节点:
- 触发器:定时、Webhook、或者手动
- Agent 节点:核心,配置模型、系统提示词、可用工具
- 工具节点:搜索、HTTP 请求、数据库查询、代码执行
- 记忆节点:保存和读取对话历史
- 条件分支:根据 Agent 输出走不同路径
关键在于,这些节点之间的数据传递是自动的。你不用手写"把上一步的 output 取出来塞进下一步的 input",点连线就完了。
为什么可视化对 Agent 开发特别有用
Agent 开发有个特点:调试成本极高。一个跑不通的 Agent,你很难一眼看出是提示词写得不好、工具返回格式不对、还是中间哪一步数据丢了。
可视化画布在这个场景下有天然优势——你能看到每一步的输入输出。点开任意节点,上次运行时它收到了什么、返回了什么,一目了然。这种可观测性在纯代码方案里要自己打日志才能实现。
第二个优势是可协作。一个画布能被产品经理、运营、工程师一起看懂。Agent 这种东西往往不是纯技术问题,业务逻辑对不对才是关键,让非工程同学能看到流程,能省掉大量来回沟通。
自托管怎么做
Sim 支持 Docker 自部署,对数据敏感的场景很重要——你的提示词、业务数据、API 密钥全留在自己机器上。
官方给的推荐路径是克隆仓库后用 Docker Compose 起。配置上要准备的是模型 API Key(OpenAI、Anthropic 或自建模型都支持)。
自托管要注意两件事:一是持久化存储要挂 volume,否则容器一重启工作流全没了;二是如果要多人协作,前面得配好反向代理和鉴权。
和 n8n、Dify 这些比呢
同类工具不少,简单给个判断:
- n8n:通用自动化最强,集成数量碾压,但 AI Agent 相关的能力相对弱一些
- Dify:更偏"快速搭一个 AI 应用",比如知识库问答,上手更快
- Sim:介于两者之间,Agent 工作流的表达能力强,同时保持了可视化
如果你的核心诉求是"搭一个会自主规划、会调工具、有记忆的 Agent",Sim 的节点设计比通用自动化工具更贴合。如果你的诉求是"把公司 50 个 SaaS 串起来",那 n8n 的集成库更实用。
上手要避开的坑
别把提示词写死在节点里到处复制。 复杂工作流里会有多个 Agent 节点,每个都嵌一大段提示词,改一处要改五处。把通用的人设、规则抽成变量或者放到一个统一的配置节点里。
工具权限要给最小集。 Agent 能调的工具越多,它越容易跑偏。只给它完成任务真正需要的那几个工具,既省 token 又降低出错概率。
一定要设最大步数。 Agent 的循环如果退出条件没写好,可能无限跑下去烧掉大量 API 费用。每个 Agent 节点都设一个明确的最大迭代次数,这是个便宜的保险。
生产环境加人工确认节点。 涉及发邮件、改数据库、对外付款这类不可逆操作的工作流,中间插一个"等待人工批准"的节点。演示环境下 Agent 表现良好,不代表生产环境不会出问题。
把 Agent 工作流做扎实的四个细节
工具描述要写得像文档。 Agent 判断用不用某个工具,靠的是工具的描述文字。写"搜索网页"和写"用关键词搜索公开网页并返回标题与摘要,适合查找时效信息",效果差别很大。工具描述是提示词的一部分,别敷衍。
给 Agent 一个明确的停止条件。 在系统提示词里写清楚"什么情况下算完成"。没有明确终止条件的 Agent 会一直循环,直到耗尽最大步数——既烧钱又给不出结果。
中间结果存下来。 长链路 Agent 每一步的输出都值得持久化,一方面方便调试(看它中间想了什么),另一方面失败后可以从中间某步重跑,不用整个重来。
成本要在工作流里可见。 每个模型调用节点记录 token 消耗,汇总到一个变量里输出。跑一次花多少钱,这才是你敢把它放到生产的前提。
常见失败模式与对策
Agent 不调工具、直接编答案。 通常是因为系统提示词没强调"必须使用工具获取信息"。加一句明确要求,并要求它在回答里引用工具返回的来源。
工具返回格式解析失败。 让工具节点强制返回 JSON schema,并在 Agent 提示词里说明格式。模型输出结构化数据的稳定性,很大程度取决于你对格式的约束强度。
工作流跑着跑着就偏离目标。 链路太长时容易"跑题"。把大任务拆成几个子工作流,每个子工作流只解决一个明确问题,用中间结果串联,比一个超长链路可靠得多。
一个具体的落地例子
假设你要做一个"竞品动态监控"的 Agent:每天早上搜一遍几个竞品的更新,总结成一份简报发到 Slack。
在 Sim 里这条流程大概是四个节点:定时触发器 → 搜索工具节点(查竞品博客和新闻)→ Agent 节点(总结成结构化简报)→ Slack 通知节点。
真正耗时的不是搭这几个节点,而是调 Agent 节点的那段提示词——要写清楚简报的格式、条数、什么算"值得关注的更新"。搭好之后跑一次看输出,不满意就改提示词再跑,这个迭代循环在可视化界面里非常快。
对比纯代码方案,你省掉的是:HTTP 请求封装、结果解析、错误处理、状态管理这些胶水。这些都由平台承担了,你只需要关心业务逻辑本身。
我的看法
可视化 Agent 构建工具最大的价值,是把"能不能做"的验证成本降到极低。以前要验证一个 Agent 想法,你得先写一周胶水代码;现在可能一个下午就能把流程搭出来跑通, confirmed 了再决定要不要工程化。
Sim 在这个赛道里是开源协议最宽松、自托管做得比较扎实的那个。有 Agent 想法但还没动手的,值得花一个下午试试。
官方仓库在 github.com/simstudioai/sim。
适合谁:想快速验证 Agent 想法的开发者、需要非工程同学参与流程设计的团队、有数据合规要求的场景