AI 短剧每秒 2 分钱:3 秒出片之后,瓶颈从「等」变成了「选」
AI 视频真正卡产能的从来不是画质,是等待。当 5 秒 768p 能在 3 秒左右出片、每秒成本压到 2 分钱,工作流就从「想完美再生成」变成「一次抽十张再挑」。但单镜头快不等于量产快——拉开差距的是并发能力和分镜拆解。这里算一笔成本账、拆一条 Agent 链路、给三条可选的上手路径,也说清还没解决的三个问题。
你有没有算过,做一条 AI 视频,真正花在"想"上的时间有多少?
大部分人的答案是:很少。真正吃掉时间的是等待。你写完提示词,点下生成,然后盯着进度条——30 秒、1 分钟、甚至更久。等画面出来,你才能判断运镜对不对、人物稳不稳、这个镜头该不该重做。一个镜头等一分钟,一集 20 个镜头就是半小时,而这半小时里你什么都没干,只是在等。
现在这个前提被改掉了。
你以为的瓶颈是画质,真正的瓶颈是等待
过去两年,AI 视频的讨论几乎全部集中在画质上:分辨率够不够、手指有没有多一根、人物会不会中途变脸。这些当然是问题,但对真正在批量产内容的人来说,画质从来不是卡住产能的那一环。
卡住产能的是反馈周期。
做视频和写代码不一样。写代码你能在脑子里推演,写完立刻跑,报错立刻看。做视频不行,你必须等模型把画面渲染出来,才能判断这次尝试是对是错。这意味着每一次迭代都要付出一次完整的等待成本。
一个镜头试 5 遍,就是 5 次等待。一集 20 个镜头,就是 100 次等待。哪怕每次只要 40 秒,累计也是一个多小时——而这一个多小时里,你的判断力是断续的,上一版的细节已经记不清了。
所以当生成时间被压到 3 秒这个量级,变化的不是"快了多少",而是工作流本身换了一种形态。
3 秒出片,把「等结果」变成「抽卡」
Fal 基于 MiniMax H3 的开放权重版本做了后训练和推理优化,推出了 H3 Max。公开实测的说法是,它的生成速度达到原版 MiniMax H3 的 35 倍;5 秒 768p 的视频,3 秒左右就能出片,最低约合每秒 2 分钱。
35 倍这个数字你不必当成精确结论去抠——不同分辨率、不同提示词复杂度下差异会很大。但你只需要抓住它带来的那一个变化:等待消失了,取而代之的是抽卡。
这两个状态的区别非常大。
- 等待模式下,你一次只敢提交一个任务,因为每一个都要付出时间成本,所以你会反复斟酌提示词,试图一次做对。
- 抽卡模式下,你一次可以提交十个变体,让模型跑完再挑。你的精力从"把提示词想完美"转移到"从结果里挑对的那个"。
前者是谨慎,后者是覆盖。当单次成本足够低,覆盖远比谨慎高效。
这不是什么新鲜道理——做图的同学早就习惯了"一张不满意就抽十张"。视频只是第一次走到了这一步。
成本账要重算:每秒 2 分钱意味着什么
我们对"视频生成贵"的印象,大部分停留在按分钟计费的旧时代。按每秒 2 分钱算,很容易得出一个反直觉的结论:
- 一条 10 秒的镜头,一次生成约 2 角钱
- 抽 5 个变体选一个,约 1 元
- 一集 20 个镜头,全部抽 5 遍,约 20 元
也就是说,二十几块钱,你可以把一集短剧的每一个镜头都试五遍,从中挑出最好的组合。
这个数字的意义不在于"便宜",而在于它把试错从成本项变成了常规动作。以前你要精打细算,现在你可以粗暴一点。粗暴在创作里不是贬义词——它意味着你愿意让模型多跑几次,愿意接受"先出结果再判断"这种更接近本能的工作方式。
当然,这是理想情况下的算术。真实消耗会更高:失败的镜头、不满意的重跑、分辨率拉高后的单价上浮。但量级不会变——从"每条几十元"降到"每条几元",这是数量级的下降。
单镜头快,不等于量产快
这里有个很容易踩的坑。
很多人看到"3 秒出片",第一反应是"那我做一集短剧只要 1 分钟"。这个推导是错的,因为一集短剧不是一条长视频,它是几十个短镜头拼起来的。
单一镜头快,只是把每个环节的时间缩短了。但如果这些镜头还是排队生成——跑完第一个再跑第二个——那么总时间依然等于所有镜头时间之和。20 个镜头,每个 10 秒,串行就是 200 秒。快吗?比过去快得多。但它没有发生质变。
真正的质变发生在并发上:20 个镜头同时提交,同时生成,总时间等于单个镜头的时间。
所以判断一个创作平台能不能真的量产,你要问的不是"它多快",而是两个问题:
- 一次能同时跑多少个任务?
- 跑满并发时,单任务速度会不会掉?
第二点尤其容易被忽略。很多平台宣传"支持高并发",但并发一上来,排队时间就悄悄加回去了。
7 个 Agent 把剧本拆成可并行的镜头
光有并发能力还不够,你得先有一堆可以同时跑的镜头。
这一步过去是人工做的:拿到剧本,自己拆成"第 1 镜、中景、男主站在门口、情绪愤怒",然后逐条写提示词。一个 5 分钟的短篇拆出 20 个镜头,光拆解就要一小时。
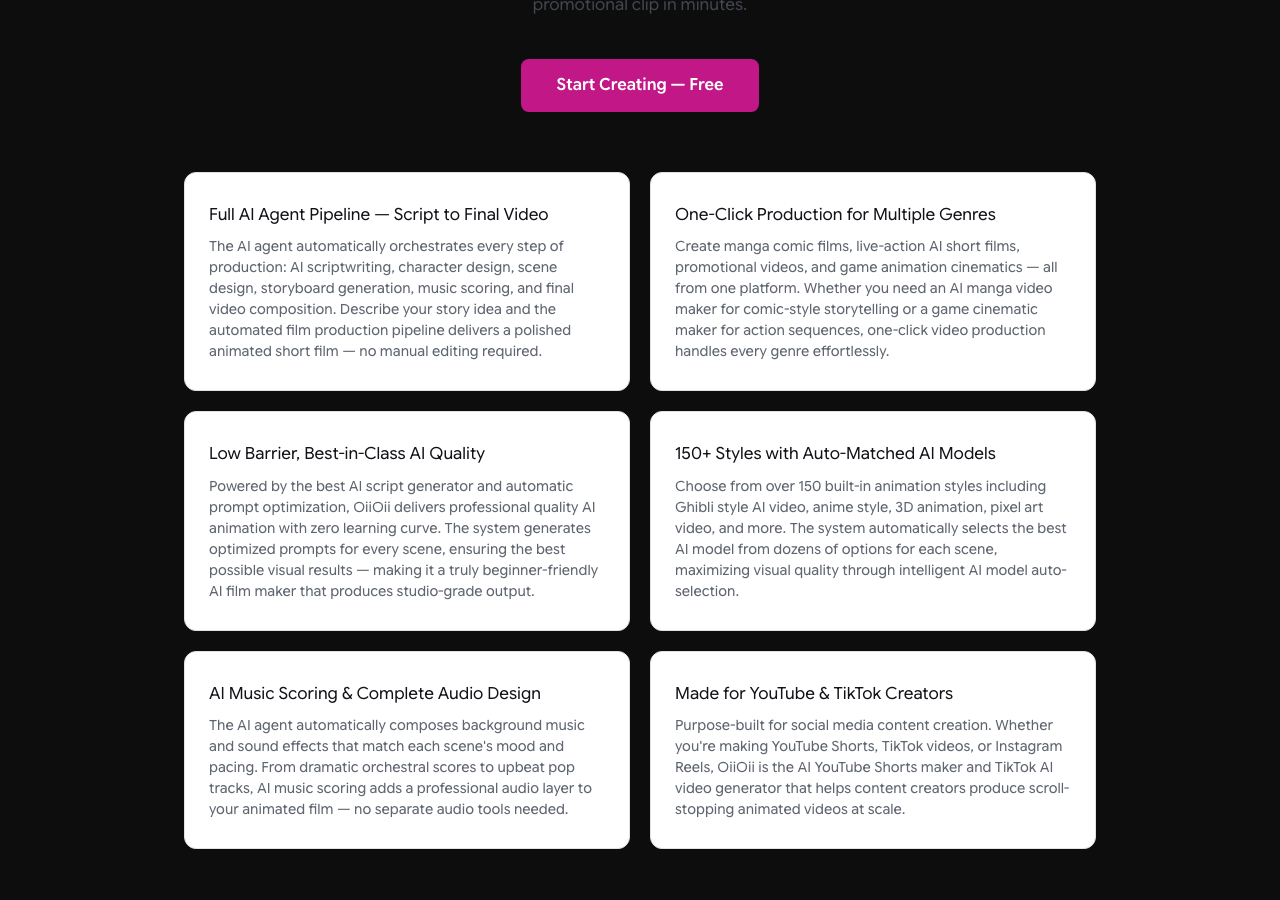
现在有平台把这件事交给了多个分工明确的 Agent。以 OiiOii 的做法为例,它内置了 7 个角色:艺术总监、编剧、角色设计师、场景设计师、道具设计师、分镜师、音效师。
这个分工不是凑数,它对应的是影视工业里真实存在的岗位划分:
- 艺术总监定整体调性,保证 20 个镜头看起来像同一部片子
- 编剧把故事拆成有节奏的段落
- 角色设计师锁定人物的一致性,避免同一个人在不同镜头里长两张脸
- 场景与道具设计师负责环境连续性
- 分镜师输出每个镜头的景别、运镜、时长
- 音效师负责声音层
你丢进去一段剧情,这条链路自动走完,输出一批结构化、可以直接送去生成的分镜。
这里最值得注意的不是"自动化",而是一致性。AI 视频量产最难的不是单镜头好看,是 20 个镜头放在一起像一部片。角色设计、场景设计这些岗位存在的意义,就是解决这件事。
20 个镜头 4 分钟:一次并发实测的时间账
有创作者跑过一个具体的例子:一段约 5 分钟、768p 的美式幽默风格短篇,20 个 15 秒镜头,从按下开始到全部产出,用了 4 分多钟。
这个数字值得拆开看。
20 个镜头、每个 15 秒,总时长是 300 秒的成片。4 分钟出全部素材,意味着生成时间已经短于成片时长本身。放在半年前,这个时间里你可能连一个镜头都等不出来。
更关键的是它改变了你的工作方式:以前你是"想好一个镜头 → 生成 → 看结果 → 想下一个",串行推进,思路不断被打断。现在你可以一次性看到整集的 20 个镜头,站在全局视角去判断节奏、取舍、哪里需要重跑。
这两种状态的产出质量不在同一个层级。前者是在拼图,后者是在剪辑。
提示词管理:模板解决「我只想跑一个镜头」
但不是每次都要做长篇。很多时候你只想验证一个效果——某个运镜能不能实现、某种风格适不适合你的题材。
这时候让 7 个 Agent 全链路跑一遍,有点重。
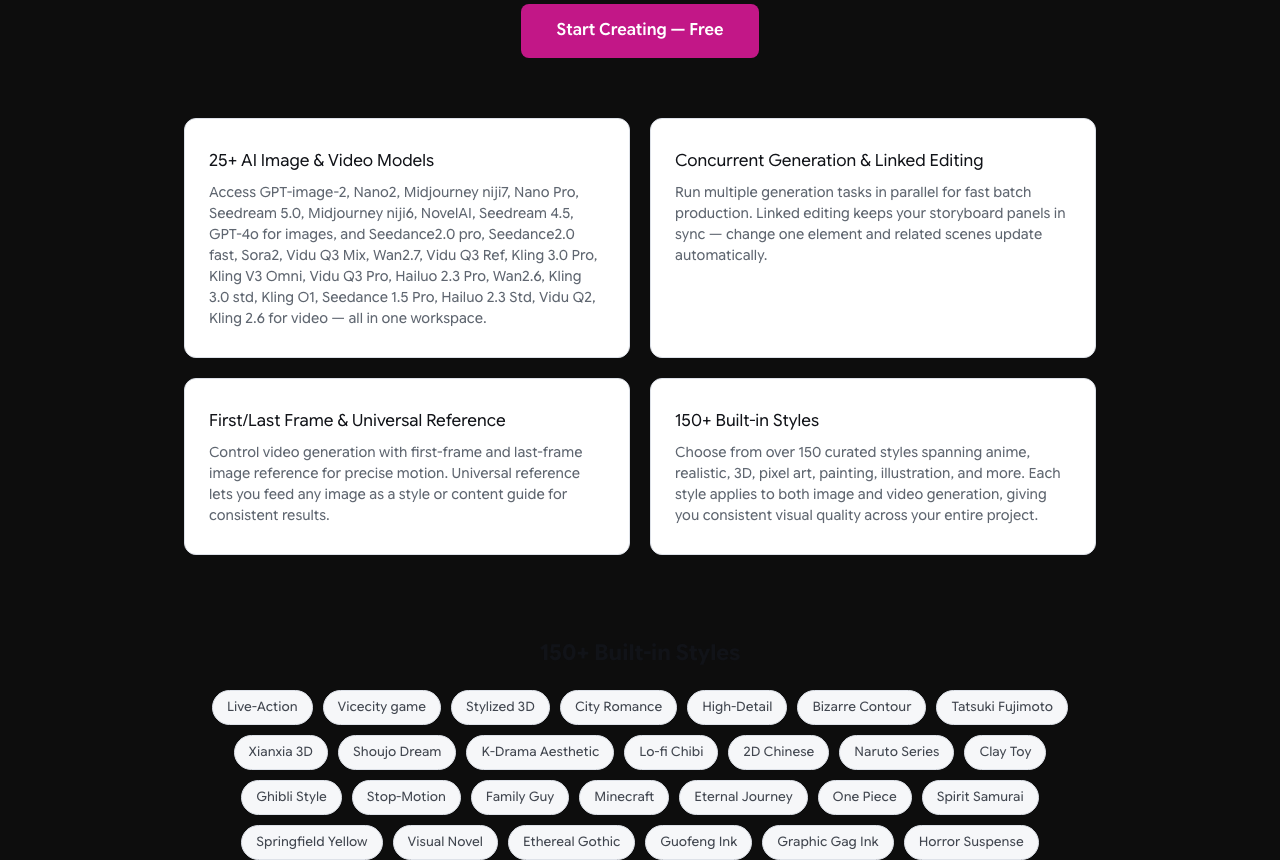
更轻的做法是用模板。OiiOii 上线了一个内置模板市场,提供近百种不同行业、不同场景的模板。你要做的不是从零写提示词,而是找一个接近的模板,改你要改的部分。
这个思路对提示词新手特别友好。写提示词最大的困难从来不是"不知道要什么",而是"不知道怎么描述"。模板直接给了你一个可运行的描述骨架,你只需要替换主体、情绪、环境这几个变量。
有创作者用这种方式跑了一个民国烟雨江南风格的分镜,768p、15 秒,10 秒左右出片。效果未必比精调提示词更好,但从想到到看到的时间被压缩到了极致。
对批量测试来说,这个速度比绝对质量更重要。你要在几十种风格里找到适合自己题材的那一种,快就是一切。
Turbo 版本:更轻、更快、更便宜的取舍
H3 Max 之外,还上线了 Turbo 版本——一个文生图、首尾帧创作模型,比 Max 更轻量,生成更快,费用更低。
这里要理解清楚 Turbo 的定位,它不是一个"更好的版本",而是一个不同用途的版本:
- Max 走的是完整视频生成,适合需要运镜、需要时间维度的镜头
- Turbo 走文生图和首尾帧,适合先定画面、再补动作的场景
首尾帧这个能力在短剧里其实很实用。很多镜头你并不需要从零生成,你只需要确定"起手什么样、落点什么样",中间交给模型补。这比完整生成更可控,也更便宜。
用黏土动画风格跑一个 768p、15 秒的儿童向内容,包含洗、切、烧、盛几个连续动作,是这类模型的舒适区。低龄向、动作简单、色彩饱和度高的内容,现在完全可以走 Turbo 批量出。
选型的判断标准很简单:先看你要的是"一段运动"还是"两个画面"。前者用 Max,后者用 Turbo。
三条可以立刻上手的路径
讲了这么多,落地部分给你三条路径,按你的现状选。
如果你还没做过 AI 视频。 别从剧本开始,从模板开始。找两三个你喜欢的风格模板,跑同样的内容,先建立对"提示词改一个词画面会怎么变"的手感。这一步的目标不是出片,是理解模型的脾气。
如果你在做中短视频,想提产能。 先把你的流程拆成"拆解"和"生成"两段,看看时间到底花在哪。大部分人的瓶颈在拆解——如果能用 Agent 链路自动出分镜,再把生成并发拉满,产能提升是数量级的。
如果你已经在批量跑。 趁着一个镜头几毛钱的时候,多做提示词验证。这个阶段最有价值的不是出片,是积累你自己的提示词库——哪些描述在你的题材上稳定生效,哪些词会触发模型的坏习惯。价格会变,这套库不会。
别急着高兴,三个问题还没解决
速度和成本确实跨过了一个门槛,但有几件事没变。
第一,一致性仍然是概率问题。角色设计 Agent 能大幅降低翻车率,但没有人能保证 20 个镜头里人物完全一致。你依然需要人工过一遍。
第二,快不等于对。生成越快,你越容易陷入"跑了很多但都没用"的状态。抽卡的前提是你知道什么是好卡,判断力依然是稀缺品。
第三,平台依赖风险。你现在用的速度和价格,绑定在具体平台的具体模型上。模型会换、价格会调、平台可能下线。真正属于你的资产,是你积累的提示词和方法论,不是某个按钮。
所以最后给一句实在的建议:把这一段低成本窗口期,用来练判断力,而不是用来堆产量。产量随时可以堆,判断力只能在反复对比中长出来。
---
关于本文数据:文中提到的生成速度、耗时与价格,来自公开实测分享与平台方公开口径,具体数值会随分辨率、提示词复杂度、平台计费策略变化。建议你用自己的账号和题材实测一遍,以实际结果为准。
适合谁:在做 AI 短剧或漫剧的内容团队、想把视频产能翻几倍的短视频创作者、正在评估要不要把分镜流程交给 Agent 的从业者、以及刚开始接触 AI 视频的新手